
Dlib-Transformer-extensions
Die Bibliothek, auf der alles beruht, was wir veröffentlichen. Dieser temporäre Fork von Dlib, der quelloffenen C++-Bibliothek für maschinelles Lernen, ist der Ort, an dem jeder Mechanismus entworfen, durch ein lauffähiges Beispiel gezeigt, gemessen und stabilisiert wird, bevor er Dlib selbst vorgeschlagen wird.
- C++14
- Boost Software License 1.0
- Kein Python in der Kette
- CUDA und OpenVINO
- 24
- Beispielprogramme, eines je Mechanismus
- 14
- bereits in Dlib aufgenommene Beiträge
- 12
- aus GGUF-Dateien gelesene Modellarchitekturen
- 0
- Python-Abhängigkeiten in der Kette
Ein temporärer Fork, mit Absicht
Dlib entwickelt sich im Tempo einer Referenzbibliothek: Jede Ergänzung muss allgemein, getestet und dokumentiert sein. Sprachmodelle bewegen sich schneller. Der Fork gibt jedem Mechanismus Raum zum Reifen und gibt ihn dann zurück: Vierzehn Beiträge sind bereits in Dlib aufgenommen, und die Produkte bauen auf dem auf, was der Fork stabilisiert hat.

Eine Bibliothek für das ganze Leben eines Modells
Ein Modell mit offenen Gewichten kommt über seine GGUF-Datei herein und wird zu einem gewöhnlichen Dlib-Netz; ein eigenes Modell beginnt mit einem Korpus. Beide gehen danach denselben Weg: spezialisieren, ableiten, ausliefern. Eine zweite Engine führt jedes unterstützte Modell ohne Neukompilierung aus.
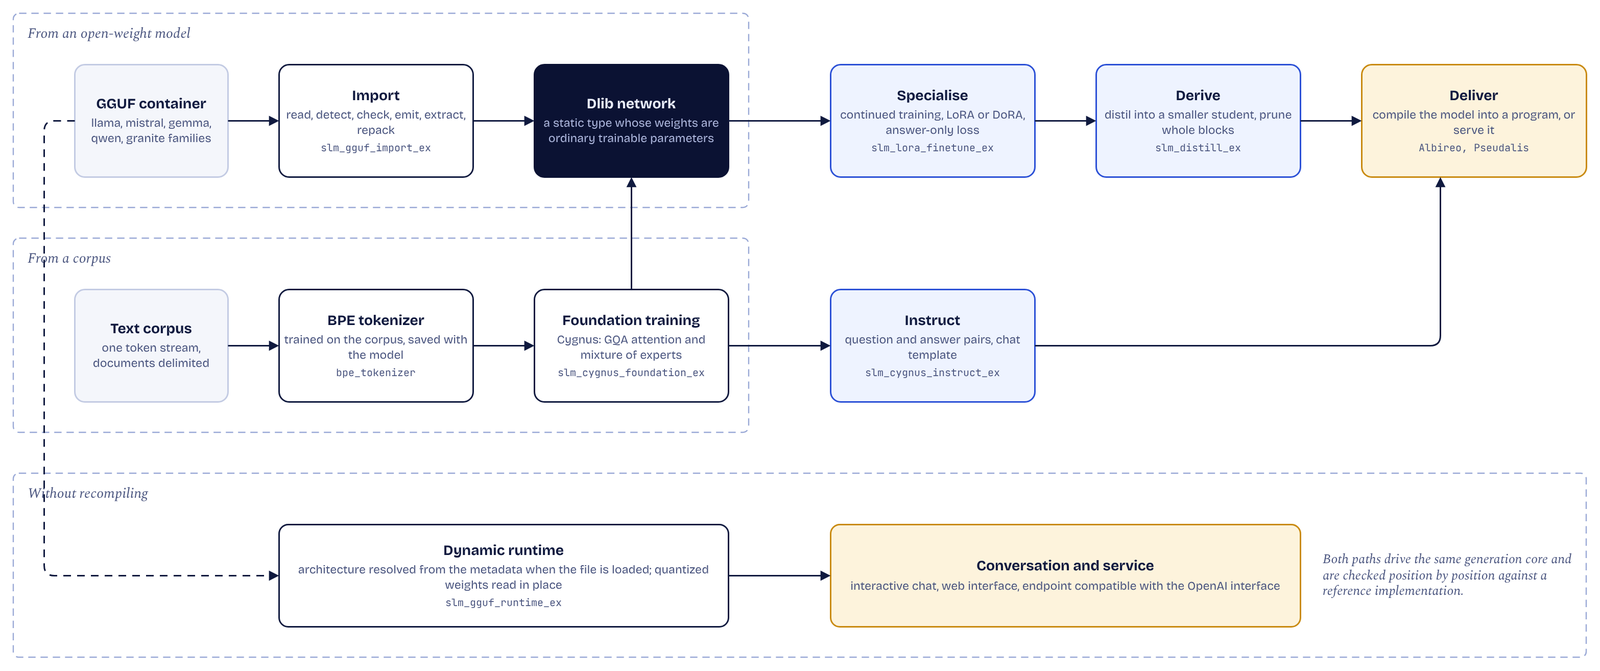
Die Architektur, Schicht für Schicht
Die Erweiterungen liegen zwischen Dlib und den Diensten der Produkte. Jede Komponentenfamilie ist für sich nutzbar: ein Tokenizer ohne die Laufzeit, der Vision-Turm ohne Sprachmodell, die Speichererweiterung unter jedem Dlib-Netz.

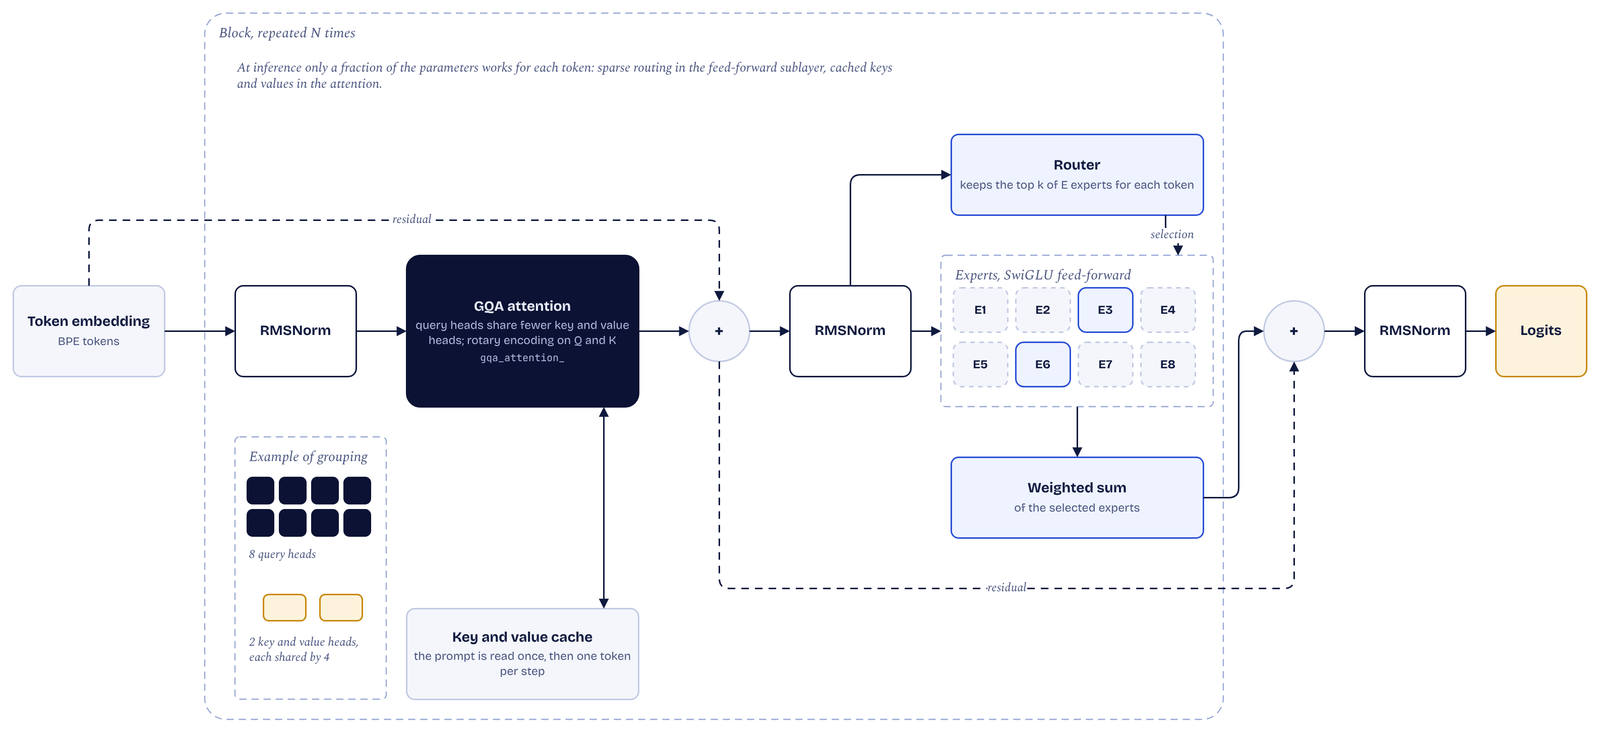
Cygnus, die Zielarchitektur
Cygnus ist die Familie kleiner Sprachmodelle auf der Architektur, auf die die Bibliothek zielt: Grouped-Query-Attention mit rotierender Positionskodierung und einem Schlüssel-Wert-Cache sowie eine Feed-forward-Teilschicht mit Expertenmischung und spärlichem Routing. Bei der Inferenz arbeitet für jedes Token nur ein Bruchteil der Parameter.
Modelle mit offenen Gewichten, importiert und geprüft
Der Import liest ein veröffentlichtes Modell in sechs Stufen und erzeugt einen Dlib-Netztyp mit seinem Tokenizer. Jede Position eines Test-Prompts wird danach mit der dynamischen Laufzeit und mit einer externen Referenzimplementierung verglichen: Ein importiertes Modell rechnet, was sein Herausgeber veröffentlicht hat.

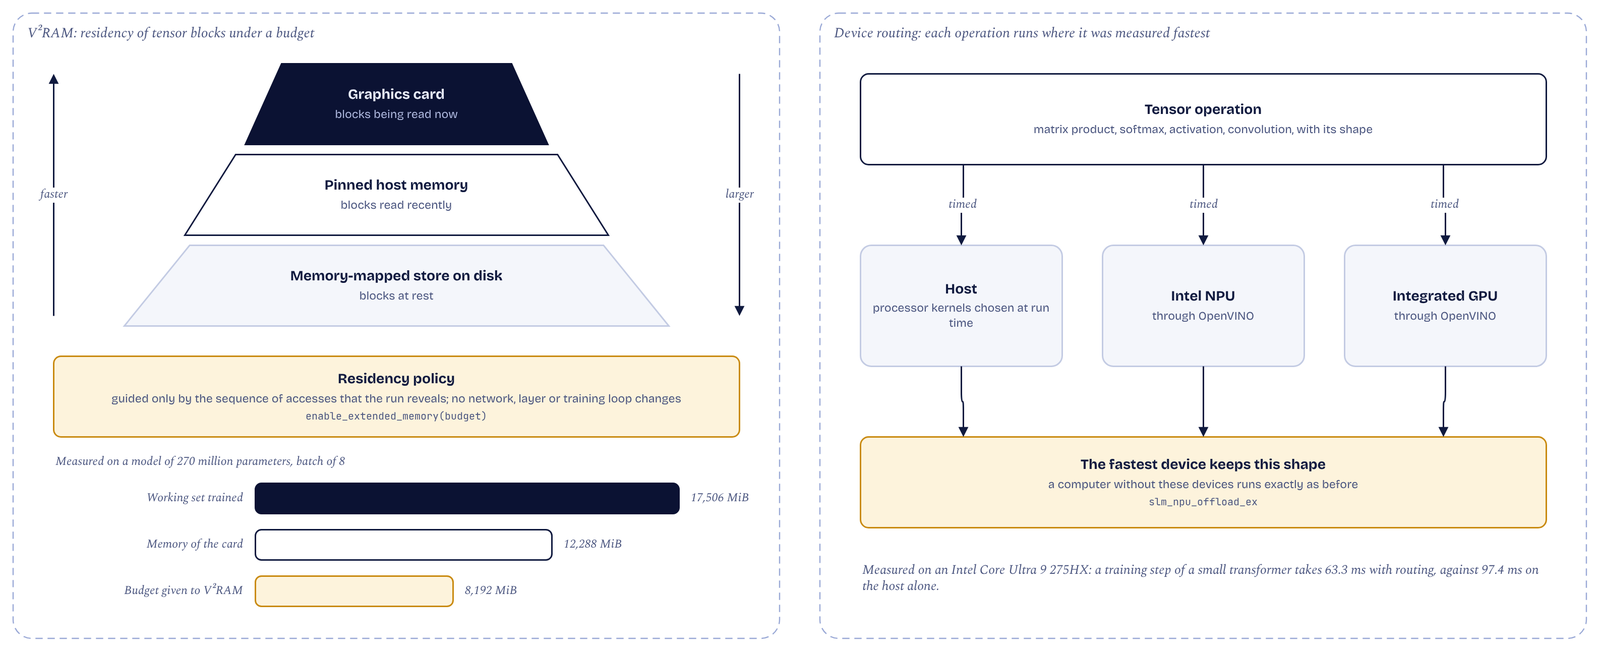
Speicher und Geräte, unterhalb des Netzes verwaltet
Zwei Mechanismen wirken unter den Schichten, ohne ein Netz oder eine Trainingsschleife zu ändern. V²RAM entscheidet, wo jeder Tensorblock liegt, unter einem Budget, das kleiner ist als das Modell. Das Geräte-Routing misst jede Operation auf dem Host, auf der NPU und auf der integrierten GPU und behält das schnellste Gerät.
24 Beispiele, eines je Mechanismus
Jeder Mechanismus der Bibliothek kommt mit einem Programm, das ihn aufbaut, ausführt und validiert: eine Dokumentation, die stets aktuell bleibt.
Erste Modelle
Ein Modell auf Zeichenebene, dann der kanonische Transformer, trainiert, bis er seinen Korpus bytegenau wiedergibt.
slm_basic_train_ex slm_advanced_train_ex slm_enwiki_train_ex
Varianten von Attention und Feed-forward
Grouped-Query-Attention, adaptive Rechenzeit, die verschmolzene Attention-Schicht mit ihrem Schlüssel-Wert-Cache, Expertenmischung.
slm_advanced_gqa_train_ex slm_advanced_gqa_kvc_train_ex slm_transformer_configs_ex
Die Cygnus-Reihe
Das Grundlagentraining auf einem Korpus, dann das Instruktionstraining und ein interaktiver Chat.
slm_cygnus_foundation_ex slm_cygnus_instruct_ex
Modelle mit offenen Gewichten
GGUF-Import und dynamische Laufzeit, Fine-Tuning mit LoRA und DoRA samt numerischer Validierung, Destillation, Embeddings und Dokumentensuche.
slm_gguf_import_ex slm_gguf_runtime_ex slm_lora_finetune_ex slm_lora_adapter_check_ex slm_distill_ex slm_embed_ex
Vision
Der Vision-Turm eines multimodalen Modells, ein von Grund auf mit CIFAR-10 trainierter Klassifikator, selbstüberwachtes Training mit Barlow Twins.
slm_vision_tower_ex slm_vit_classify_ex slm_vit_ssl_ex
Speicher und Geräte
Ein Netz, das größer ist als die Grafikkarte, und Operationen, die an die NPU und die integrierte GPU geleitet werden.
slm_extended_memory_ex slm_npu_offload_ex
Schlussfolgern und Anwendungen
Hierarchisches Schlussfolgern auf Sudoku-Extreme und ARC-AGI, Anonymisierung von Dokumenten, verlustfreie Kompression durch Vorhersage.
slm_hrm_sudoku_ex slm_hrm_arc_puzzle_ex slm_document_anonymizer_ex slm_predictive_compressor_ex slm_tok_predictive_compressor_ex
Laufende Arbeiten zur Erweiterung der Bibliothek
- QLoRA
- Die eingefrorene Basis während der Feinabstimmung quantisiert im Speicher halten.
- Präferenzoptimierung
- DPO mit der eingefrorenen Referenz aus demselben Netz, dessen Adapter neutralisiert sind.
- Expertenmischung auf dem statischen Pfad
- Diese Modelle wie alle anderen trainierbar und umwandelbar machen.
- Ein eigenes Modell der Bibliothek
- Ein kleines Sprachmodell auf einer hier gewählten Topologie und einem hier gewählten Vokabular.
Nutzen Sie die Bibliothek, oder tragen Sie zu ihrer Entwicklung bei
Der Code ist öffentlich, unter einer freizügigen Lizenz. Beiträge, Förderung und Partnerschaften bringen die Bibliothek voran.