
Dlib-Transformer-extensions
La bibliothèque sur laquelle repose tout ce que nous publions. Ce fork temporaire de Dlib, la bibliothèque C++ open source d'apprentissage automatique, est le lieu où chaque mécanisme est conçu, démontré par un exemple exécutable, mesuré et stabilisé avant d'être proposé à Dlib.
- C++14
- Boost Software License 1.0
- Aucun Python dans la chaîne
- CUDA et OpenVINO
- 24
- programmes d'exemple, un par mécanisme
- 14
- contributions déjà intégrées à Dlib
- 12
- architectures de modèles lues depuis des fichiers GGUF
- 0
- dépendance Python dans la chaîne
Un fork temporaire, par choix
Dlib avance au rythme d'une bibliothèque de référence : chaque ajout doit être général, testé et documenté. Les modèles de langage vont plus vite. Le fork laisse à chaque mécanisme le temps de mûrir, puis le reverse à Dlib : quatorze contributions y ont déjà été intégrées, et les produits s'appuient sur ce que le fork a stabilisé.

Une seule bibliothèque pour toute la vie d'un modèle
Un modèle à poids ouverts entre par son fichier GGUF et devient un réseau Dlib ordinaire ; un modèle maison part d'un corpus. Les deux suivent ensuite le même chemin : spécialiser, dériver, livrer. Un second moteur exécute tout modèle pris en charge sans recompilation.
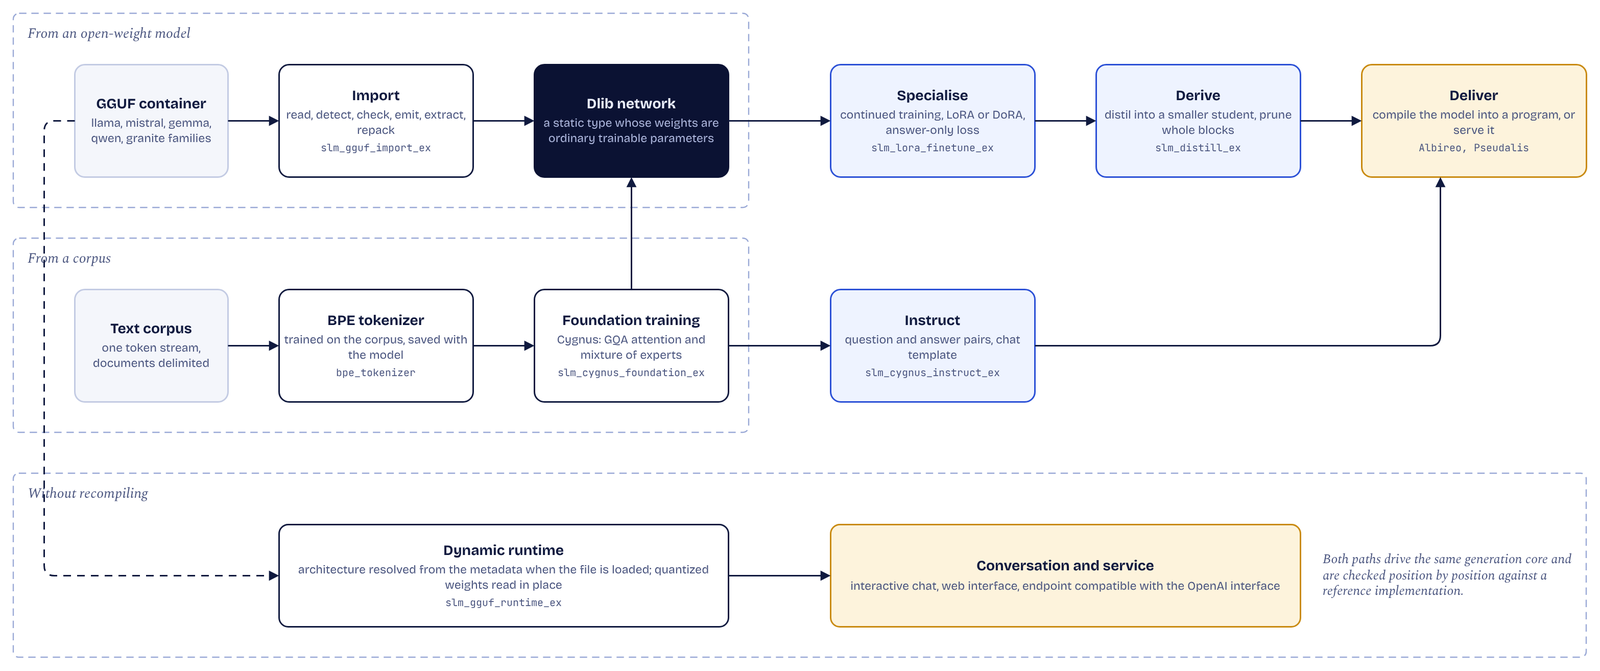
L'architecture, couche par couche
Les extensions se placent entre Dlib et les services des produits. Chaque famille de composants s'utilise seule : un tokenizer sans le moteur d'exécution, la tour de vision sans modèle de langage, l'extension mémoire sous n'importe quel réseau Dlib.

Cygnus, l'architecture cible
Cygnus est la famille de petits modèles de langage construite sur l'architecture visée par la bibliothèque : une attention à requêtes groupées avec encodage positionnel rotatif et cache des clés et des valeurs, et une sous-couche à mélange d'experts à routage parcimonieux. À l'inférence, seule une fraction des paramètres travaille pour chaque jeton.
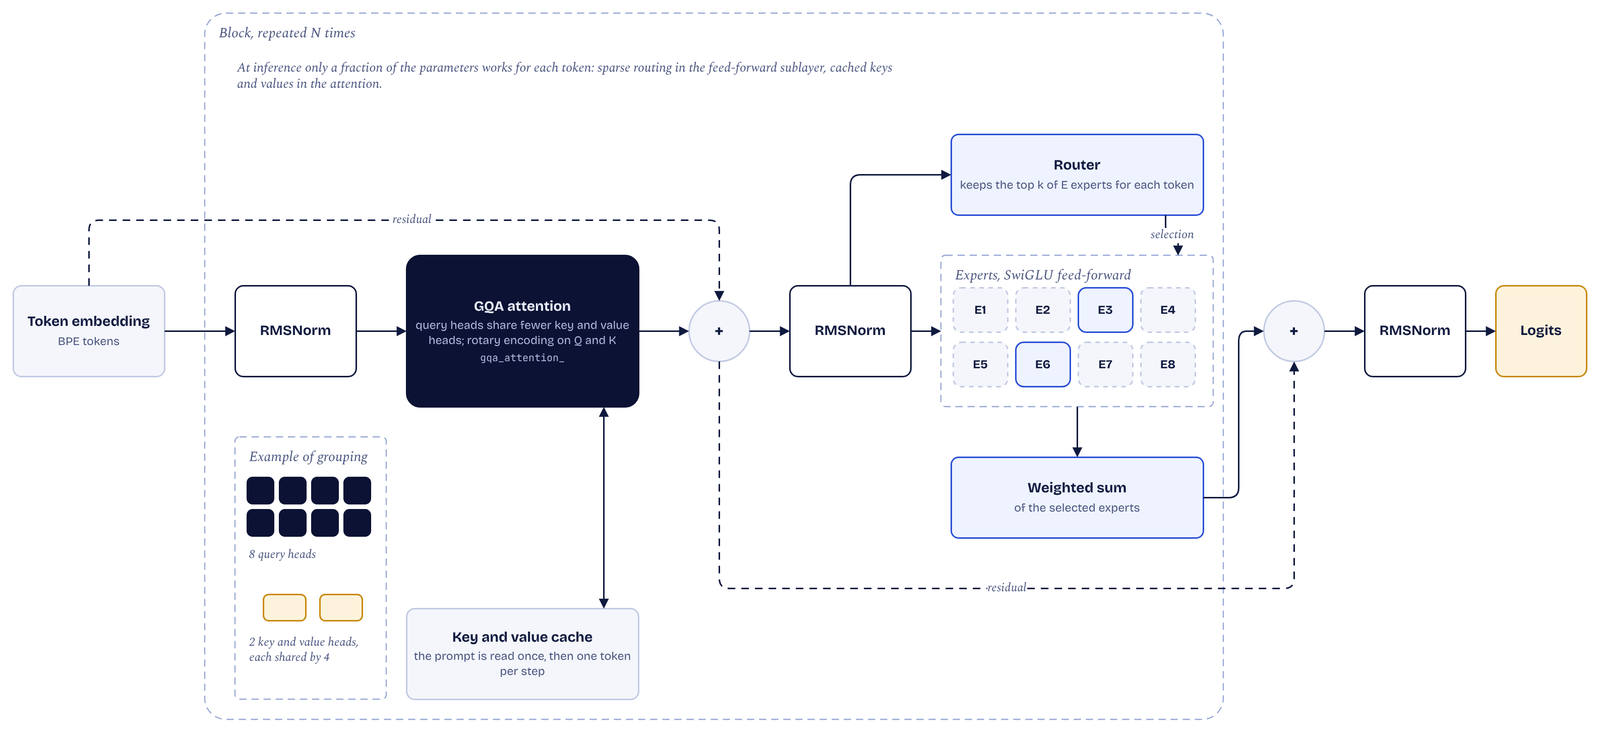
Des modèles à poids ouverts, importés et vérifiés
L'import lit un modèle publié en six étapes et produit un type de réseau Dlib avec son tokenizer. Chaque position d'un prompt de test est ensuite comparée au moteur dynamique et à une implémentation de référence externe : un modèle importé calcule ce que son éditeur a publié.

La mémoire et les processeurs, gérés sous le réseau
Deux mécanismes agissent sous les couches, sans modifier un réseau ni une boucle d'apprentissage. V²RAM décide où réside chaque bloc de tenseurs, sous un budget inférieur à la taille du modèle. Le routage chronomètre chaque opération sur l'hôte, sur le NPU et sur le GPU intégré, et retient le plus rapide.
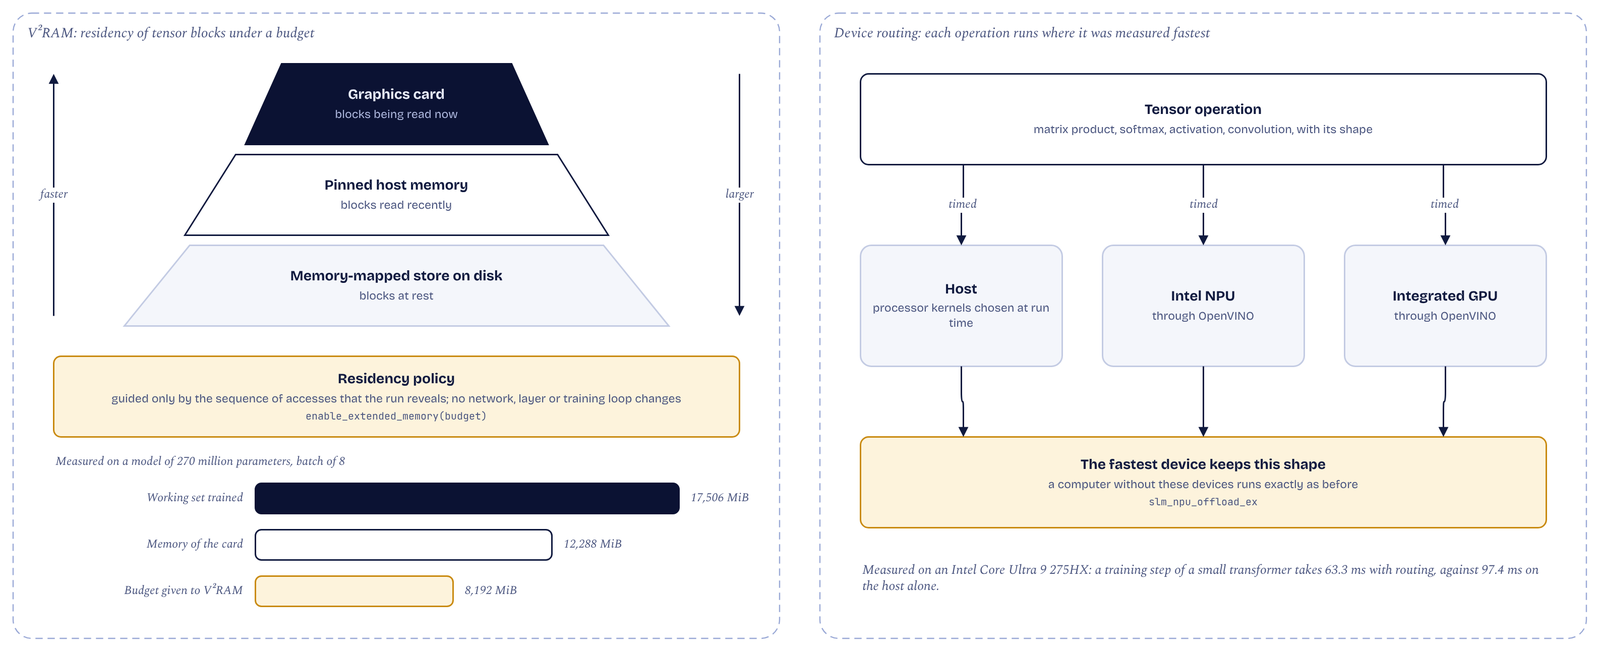
24 exemples, un par mécanisme
Chaque mécanisme de la bibliothèque est livré avec un programme qui le construit, l'exécute et le valide : une documentation qui reste toujours à jour.
Premiers modèles
Un modèle au niveau du caractère, puis le transformer canonique, entraîné jusqu'à restituer son corpus à l'octet près.
slm_basic_train_ex slm_advanced_train_ex slm_enwiki_train_ex
Variantes d'attention et de propagation
Attention à requêtes groupées, temps de calcul adaptatif, couche d'attention fusionnée avec son cache des clés et des valeurs, mélange d'experts.
slm_advanced_gqa_train_ex slm_advanced_gqa_kvc_train_ex slm_transformer_configs_ex
La série Cygnus
Le pré-entraînement de fondation sur un corpus, puis le réglage par instructions et une discussion interactive.
slm_cygnus_foundation_ex slm_cygnus_instruct_ex
Modèles à poids ouverts
Import GGUF et moteur dynamique, fine-tuning LoRA et DoRA avec sa validation numérique, distillation, embeddings et recherche documentaire.
slm_gguf_import_ex slm_gguf_runtime_ex slm_lora_finetune_ex slm_lora_adapter_check_ex slm_distill_ex slm_embed_ex
Vision
La tour de vision d'un modèle multimodal, un classifieur entraîné de zéro sur CIFAR-10, un apprentissage auto-supervisé avec Barlow Twins.
slm_vision_tower_ex slm_vit_classify_ex slm_vit_ssl_ex
Mémoire et processeurs
Un réseau plus grand que la carte graphique, et des opérations routées vers le NPU et le GPU intégré.
slm_extended_memory_ex slm_npu_offload_ex
Raisonnement et applications
Raisonnement hiérarchique sur Sudoku-Extreme et ARC-AGI, anonymisation de documents, compression sans perte par prédiction.
slm_hrm_sudoku_ex slm_hrm_arc_puzzle_ex slm_document_anonymizer_ex slm_predictive_compressor_ex slm_tok_predictive_compressor_ex
Travaux en cours pour étendre les capacités de la bibliothèque
- QLoRA
- Garder la base gelée quantifiée en mémoire pendant l'affinage.
- Optimisation par préférences
- DPO avec la référence gelée obtenue du même réseau, ses adaptateurs neutralisés.
- Mélange d'experts sur le chemin statique
- Rendre ces modèles entraînables et convertibles comme les autres.
- Un modèle propre à la bibliothèque
- Un petit modèle de langage sur une topologie et un vocabulaire choisis ici.
Utilisez la bibliothèque, ou contribuez à son développement
Le code est public, sous licence permissive. Contributions, mécénat et partenariats font progresser la bibliothèque.