
Dlib-Transformer-extensions
我们发布的一切都建立在这个库之上。它是开源 C++ 机器学习库 Dlib 的一个临时分支:每种机制都在这里设计,用可运行的示例演示,经过测量并稳定下来,然后才提交给 Dlib 本身。
- C++14
- Boost Software License 1.0
- 全程不依赖 Python
- CUDA 与 OpenVINO
- 24
- 个示例程序,每种机制一个
- 14
- 项贡献已合并进 Dlib
- 12
- 种可从 GGUF 文件读取的模型架构
- 0
- 全程零 Python 依赖
有意为之的临时分支
Dlib 按照标杆库的节奏演进:每项新增内容都必须通用、经过测试并配有文档。语言模型的发展则更快。这个分支给每种机制留出成熟的空间,然后把它交还上游:已有十四项贡献合并进 Dlib,而产品正是建立在分支已稳定的成果之上。

一个库,覆盖模型的整个生命周期
开放权重模型通过它的 GGUF 文件进入,成为一个普通的 Dlib 网络;我们自己的模型则从语料起步。此后两者走同一条路:专门化、派生、交付。另有第二个引擎,无需重新编译即可运行任何受支持的模型。
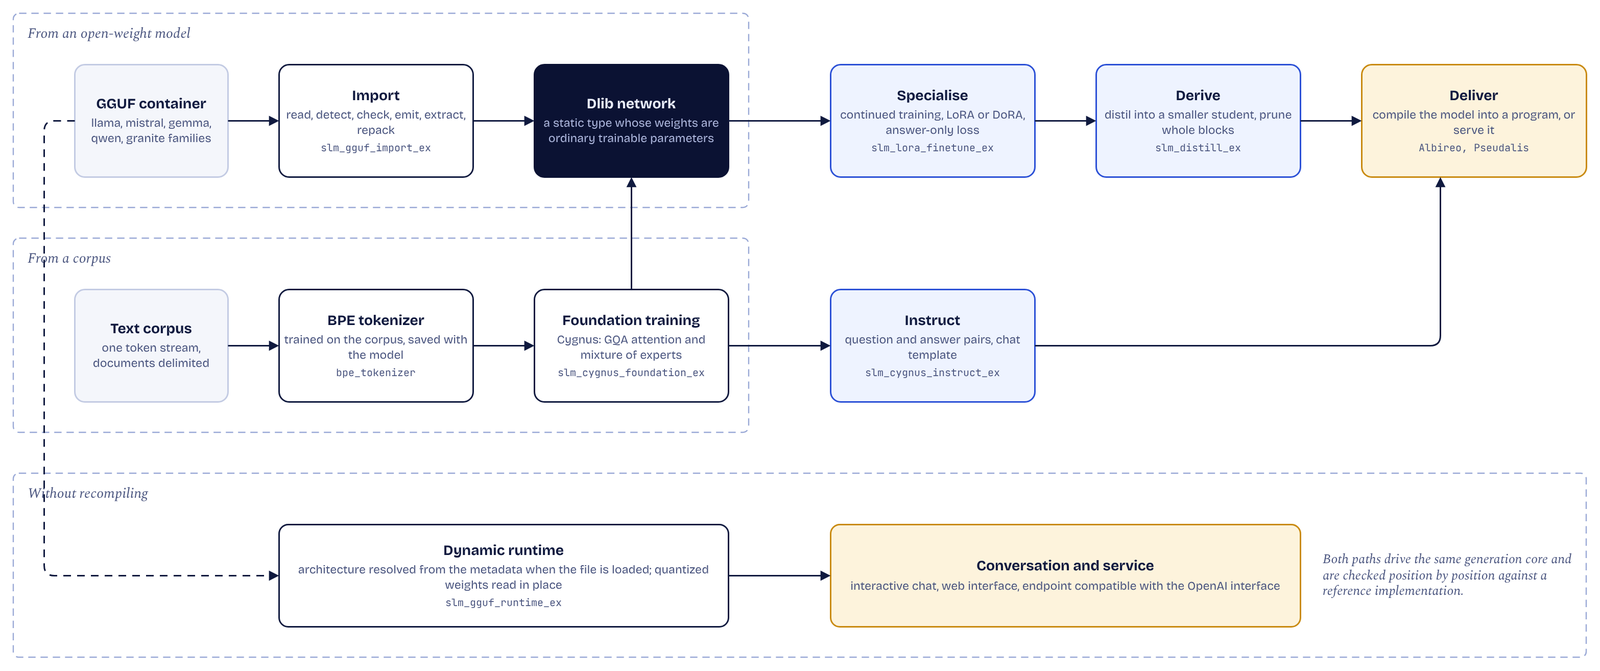
逐层看架构
这些扩展位于 Dlib 与产品的服务之间。每一类组件都可以单独使用:不带运行时的分词器,不带语言模型的视觉塔,以及可置于任何 Dlib 网络之下的显存扩展。

Cygnus,目标架构
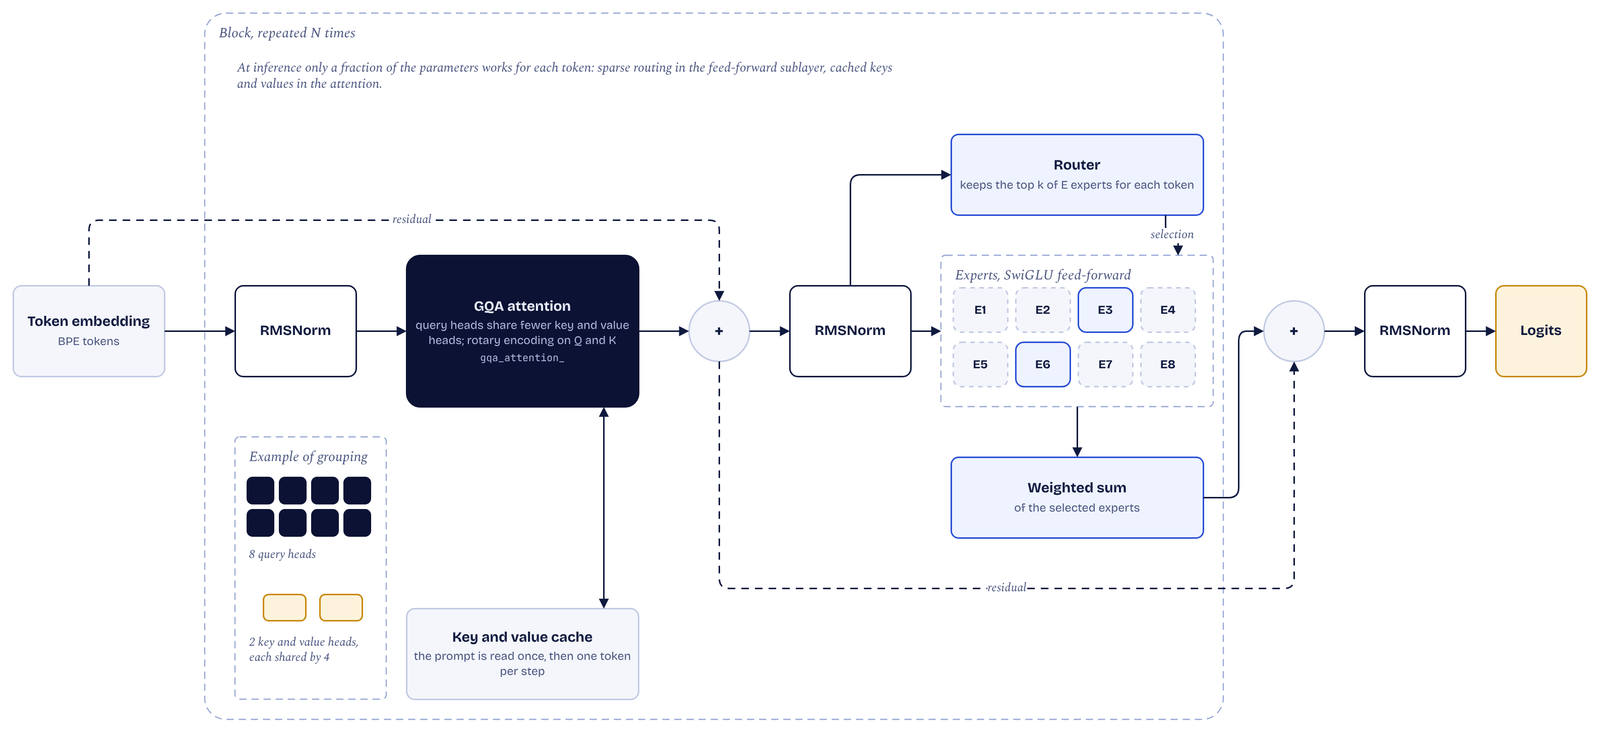
Cygnus 是一个小型语言模型系列,建立在核心库所瞄准的架构之上:带旋转位置编码和键值缓存的分组查询注意力,以及采用稀疏路由的专家混合前馈子层。推理时,每个词元只动用一小部分参数。
开放权重模型:导入并验证
导入过程分六个阶段读取一个已发布的模型,生成带分词器的 Dlib 网络类型。随后,测试提示的每个位置都会与动态运行时以及外部参考实现逐一比对:导入后的模型,算出的就是发布方发布的结果。

内存与设备:在网络之下管理
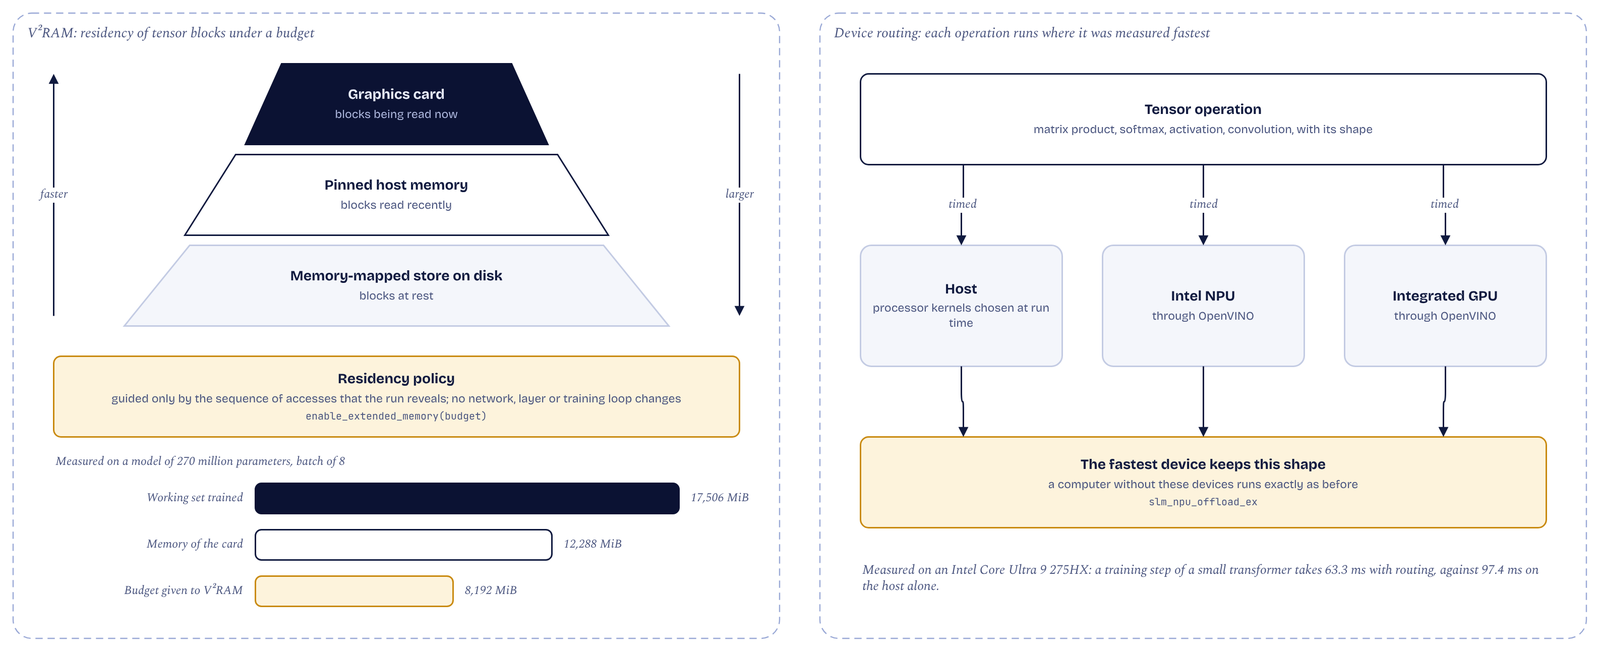
有两种机制在层的下方起作用,网络和训练循环都无需改动。V²RAM 在小于模型的预算内决定每个张量数据块的驻留位置。设备路由则在主机、NPU 和集成 GPU 上为每个运算计时,并保留最快者。
24 个示例,每种机制一个
核心库的每种机制都配有一个程序,负责构建它、运行它并验证它:一份始终保持最新的文档。
最初的模型
先是字符级模型,然后是标准 transformer,一直训练到能逐字节复现其语料。
slm_basic_train_ex slm_advanced_train_ex slm_enwiki_train_ex
注意力与前馈的变体
分组查询注意力、自适应计算时间、带键值缓存的融合注意力层、专家混合。
slm_advanced_gqa_train_ex slm_advanced_gqa_kvc_train_ex slm_transformer_configs_ex
Cygnus 系列
在语料上做基础预训练,然后是指令微调和交互式对话。
slm_cygnus_foundation_ex slm_cygnus_instruct_ex
开放权重模型
GGUF 导入与动态运行时、带数值验证的 LoRA 和 DoRA 微调、蒸馏、嵌入与文档检索。
slm_gguf_import_ex slm_gguf_runtime_ex slm_lora_finetune_ex slm_lora_adapter_check_ex slm_distill_ex slm_embed_ex
视觉
多模态模型的视觉塔、在 CIFAR-10 上从零训练的分类器、基于 Barlow Twins 的自监督训练。
slm_vision_tower_ex slm_vit_classify_ex slm_vit_ssl_ex
内存与设备
比显卡更大的网络,以及路由到 NPU 和集成 GPU 的运算。
slm_extended_memory_ex slm_npu_offload_ex
推理与应用
Sudoku-Extreme 和 ARC-AGI 上的分层推理、文档匿名化、预测式无损压缩。
slm_hrm_sudoku_ex slm_hrm_arc_puzzle_ex slm_document_anonymizer_ex slm_predictive_compressor_ex slm_tok_predictive_compressor_ex
正在进行的工作:扩展核心库的能力
- QLoRA
- 微调期间让冻结的基座模型在内存中保持量化。
- 偏好优化
- DPO,其冻结的参考模型取自同一个网络,只需让适配器失效。
- 静态路径上的专家混合
- 让这类模型像其他模型一样可以训练和转换。
- 核心库自己的模型
- 一个小型语言模型,拓扑和词表都在这里选定。