
Dlib-Transformer-extensions
La libreria su cui poggia tutto ciò che pubblichiamo. Questo fork temporaneo di Dlib, la libreria C++ open source di apprendimento automatico, è il luogo in cui ogni meccanismo è progettato, dimostrato da un esempio eseguibile, misurato e stabilizzato prima di essere proposto a Dlib.
- C++14
- Boost Software License 1.0
- Nessun Python nella catena
- CUDA e OpenVINO
- 24
- programmi di esempio, uno per meccanismo
- 14
- contributi già integrati in Dlib
- 12
- architetture di modelli lette da file GGUF
- 0
- dipendenze Python nella catena
Un fork temporaneo, per scelta
Dlib avanza al ritmo di una libreria di riferimento: ogni aggiunta deve essere generale, testata e documentata. I modelli linguistici vanno più veloci. Il fork lascia a ogni meccanismo il tempo di maturare, poi lo restituisce a Dlib: quattordici contributi vi sono già stati integrati, e i prodotti poggiano su ciò che il fork ha stabilizzato.

Una sola libreria per tutta la vita di un modello
Un modello a pesi aperti entra dal suo file GGUF e diventa una normale rete Dlib; un modello nostro parte da un corpus. Entrambi seguono poi lo stesso percorso: specializzare, derivare, consegnare. Un secondo motore esegue qualsiasi modello supportato senza ricompilare.
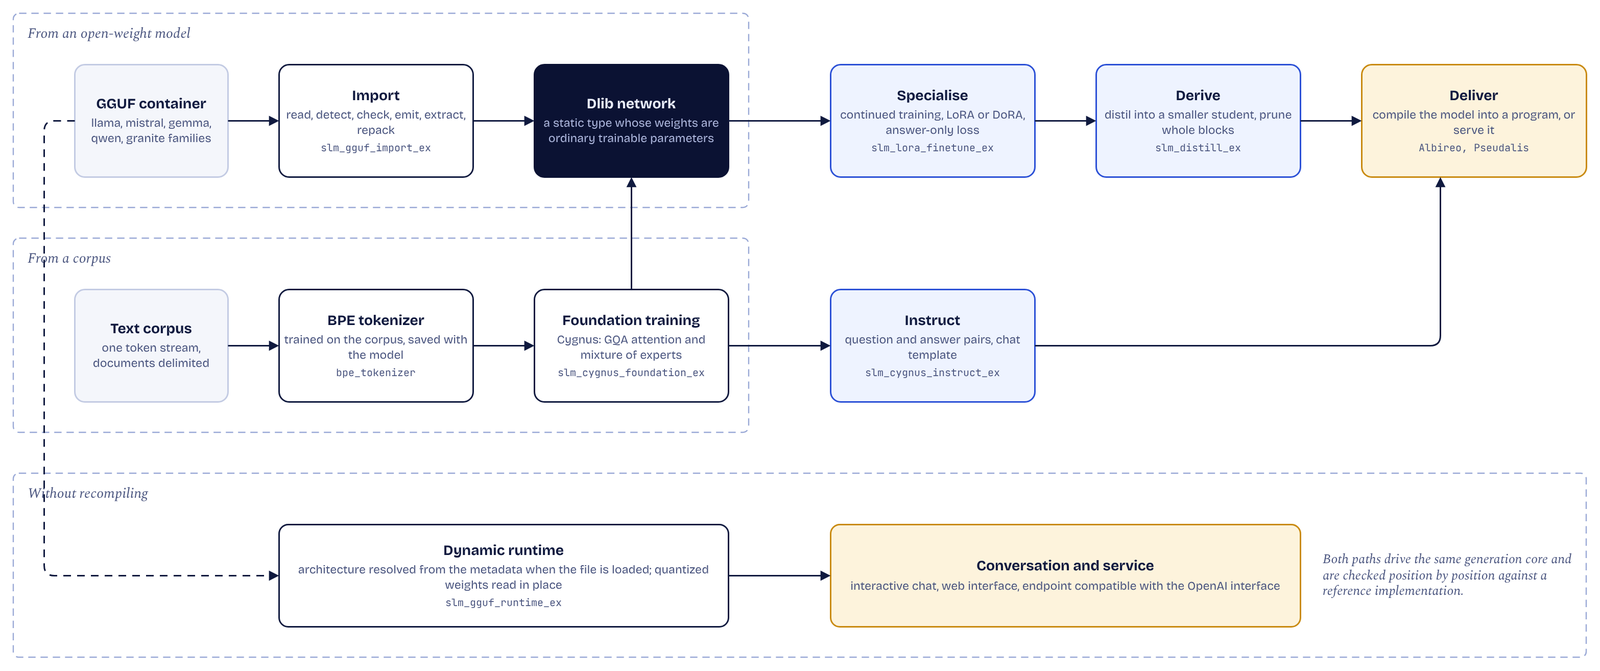
L'architettura, livello per livello
Le estensioni si collocano tra Dlib e i servizi dei prodotti. Ogni famiglia di componenti si usa da sola: un tokenizer senza il motore di esecuzione, la torre di visione senza modello linguistico, l'estensione di memoria sotto qualsiasi rete Dlib.

Cygnus, l'architettura di riferimento
Cygnus è la famiglia di piccoli modelli linguistici costruita sull'architettura a cui mira la libreria: un'attenzione a query raggruppate con codifica posizionale rotativa e cache di chiavi e valori, e un sottolivello a miscela di esperti con instradamento sparso. In inferenza, solo una frazione dei parametri lavora per ogni token.
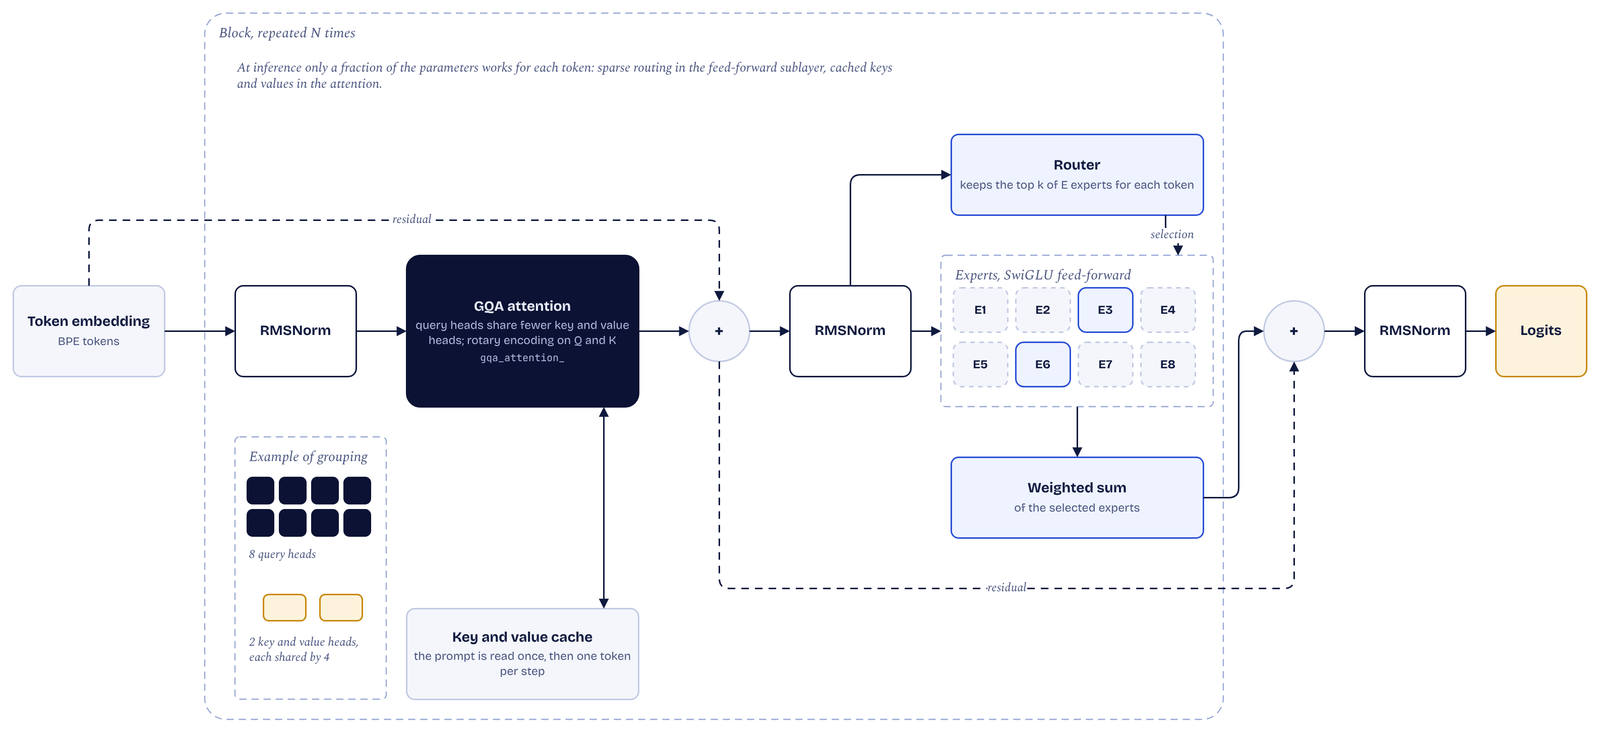
Modelli a pesi aperti, importati e verificati
L'importazione legge un modello pubblicato in sei fasi e produce un tipo di rete Dlib con il suo tokenizer. Ogni posizione di un prompt di prova è poi confrontata con il motore dinamico e con un'implementazione di riferimento esterna: un modello importato calcola ciò che il suo editore ha pubblicato.

Memoria e dispositivi, gestiti sotto la rete
Due meccanismi agiscono sotto i livelli, senza modificare una rete né un ciclo di addestramento. V²RAM decide dove risiede ogni blocco di tensori, entro un budget inferiore alla dimensione del modello. L'instradamento cronometra ogni operazione sull'host, sulla NPU e sulla GPU integrata, e conserva il più veloce.
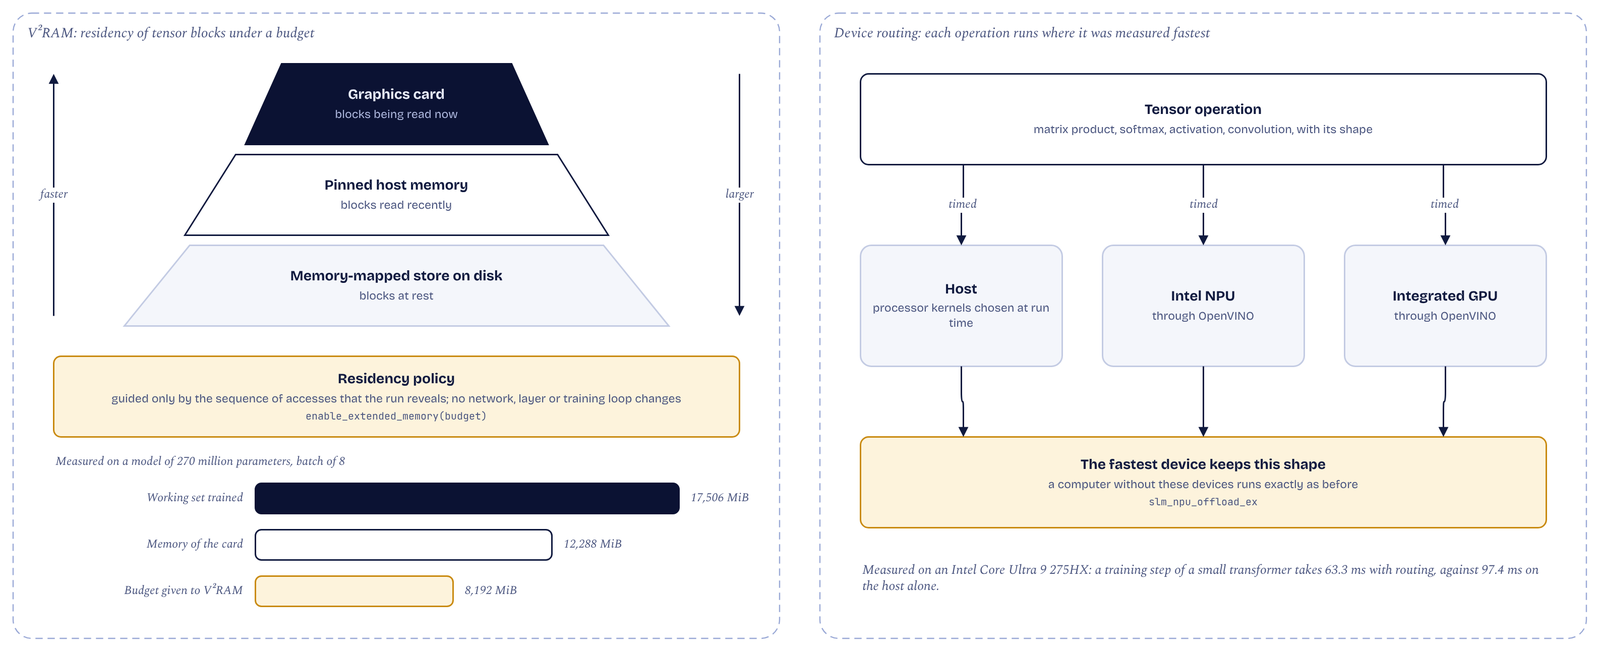
24 esempi, uno per meccanismo
Ogni meccanismo della libreria è accompagnato da un programma che lo costruisce, lo esegue e lo valida: una documentazione che resta sempre aggiornata.
Primi modelli
Un modello a livello di carattere, poi il transformer canonico, addestrato fino a restituire il suo corpus byte per byte.
slm_basic_train_ex slm_advanced_train_ex slm_enwiki_train_ex
Varianti di attenzione e di feed-forward
Attenzione a query raggruppate, tempo di calcolo adattivo, il livello di attenzione fuso con la sua cache di chiavi e valori, miscela di esperti.
slm_advanced_gqa_train_ex slm_advanced_gqa_kvc_train_ex slm_transformer_configs_ex
La serie Cygnus
Il pre-addestramento di base su un corpus, poi la messa a punto per istruzioni e una chat interattiva.
slm_cygnus_foundation_ex slm_cygnus_instruct_ex
Modelli a pesi aperti
Importazione GGUF e motore dinamico, fine-tuning LoRA e DoRA con la sua validazione numerica, distillazione, embedding e ricerca documentale.
slm_gguf_import_ex slm_gguf_runtime_ex slm_lora_finetune_ex slm_lora_adapter_check_ex slm_distill_ex slm_embed_ex
Visione
La torre di visione di un modello multimodale, un classificatore addestrato da zero su CIFAR-10, un addestramento auto-supervisionato con Barlow Twins.
slm_vision_tower_ex slm_vit_classify_ex slm_vit_ssl_ex
Memoria e dispositivi
Una rete più grande della scheda grafica, e operazioni instradate verso la NPU e la GPU integrata.
slm_extended_memory_ex slm_npu_offload_ex
Ragionamento e applicazioni
Ragionamento gerarchico su Sudoku-Extreme e ARC-AGI, anonimizzazione di documenti, compressione senza perdita per predizione.
slm_hrm_sudoku_ex slm_hrm_arc_puzzle_ex slm_document_anonymizer_ex slm_predictive_compressor_ex slm_tok_predictive_compressor_ex
Lavori in corso per estendere le capacità della libreria
- QLoRA
- Tenere la base congelata quantizzata in memoria durante l'affinamento.
- Ottimizzazione per preferenze
- DPO con il riferimento congelato ottenuto dalla stessa rete, con gli adattatori neutralizzati.
- Miscela di esperti sul percorso statico
- Rendere questi modelli addestrabili e convertibili come gli altri.
- Un modello proprio della libreria
- Un piccolo modello linguistico su una topologia e un vocabolario scelti qui.
Usate la libreria, o contribuite al suo sviluppo
Il codice è pubblico, sotto licenza permissiva. Contributi, sponsorizzazioni e collaborazioni fanno avanzare la libreria.