
Dlib-Transformer-extensions
La biblioteca en la que se apoya todo lo que publicamos. Este fork temporal de Dlib, la biblioteca C++ de código abierto de aprendizaje automático, es el lugar donde cada mecanismo se diseña, se demuestra con un ejemplo ejecutable, se mide y se estabiliza antes de proponerlo a Dlib.
- C++14
- Boost Software License 1.0
- Sin Python en la cadena
- CUDA y OpenVINO
- 24
- programas de ejemplo, uno por mecanismo
- 14
- contribuciones ya integradas en Dlib
- 12
- arquitecturas de modelos leídas de archivos GGUF
- 0
- dependencias de Python en la cadena
Un fork temporal, por decisión propia
Dlib avanza al ritmo de una biblioteca de referencia: cada adición debe ser general, estar probada y documentada. Los modelos de lenguaje van más deprisa. El fork da a cada mecanismo tiempo para madurar y después lo devuelve a Dlib: catorce contribuciones ya se han integrado en ella, y los productos se apoyan en lo que el fork ha estabilizado.

Una sola biblioteca para toda la vida de un modelo
Un modelo de pesos abiertos entra por su archivo GGUF y se convierte en una red Dlib ordinaria; un modelo propio parte de un corpus. Ambos siguen después el mismo camino: especializar, derivar, entregar. Un segundo motor ejecuta cualquier modelo compatible sin recompilar.
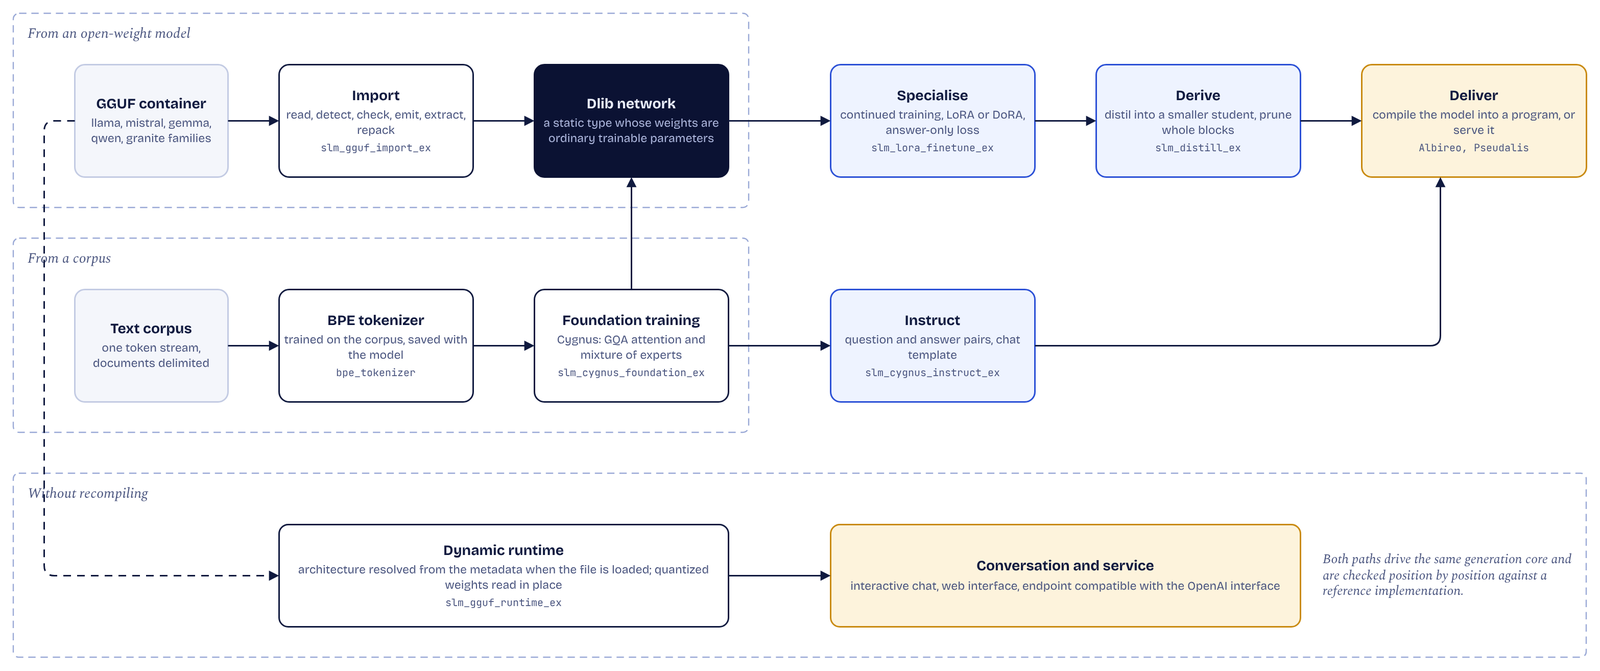
La arquitectura, capa por capa
Las extensiones se sitúan entre Dlib y los servicios de los productos. Cada familia de componentes se usa por separado: un tokenizador sin el motor de ejecución, la torre de visión sin modelo de lenguaje, la ampliación de memoria bajo cualquier red Dlib.

Cygnus, la arquitectura objetivo
Cygnus es la familia de pequeños modelos de lenguaje construida sobre la arquitectura a la que apunta la biblioteca: una atención de consultas agrupadas con codificación posicional rotatoria y caché de claves y valores, y una subcapa de mezcla de expertos con enrutamiento disperso. En inferencia, solo una fracción de los parámetros trabaja para cada token.
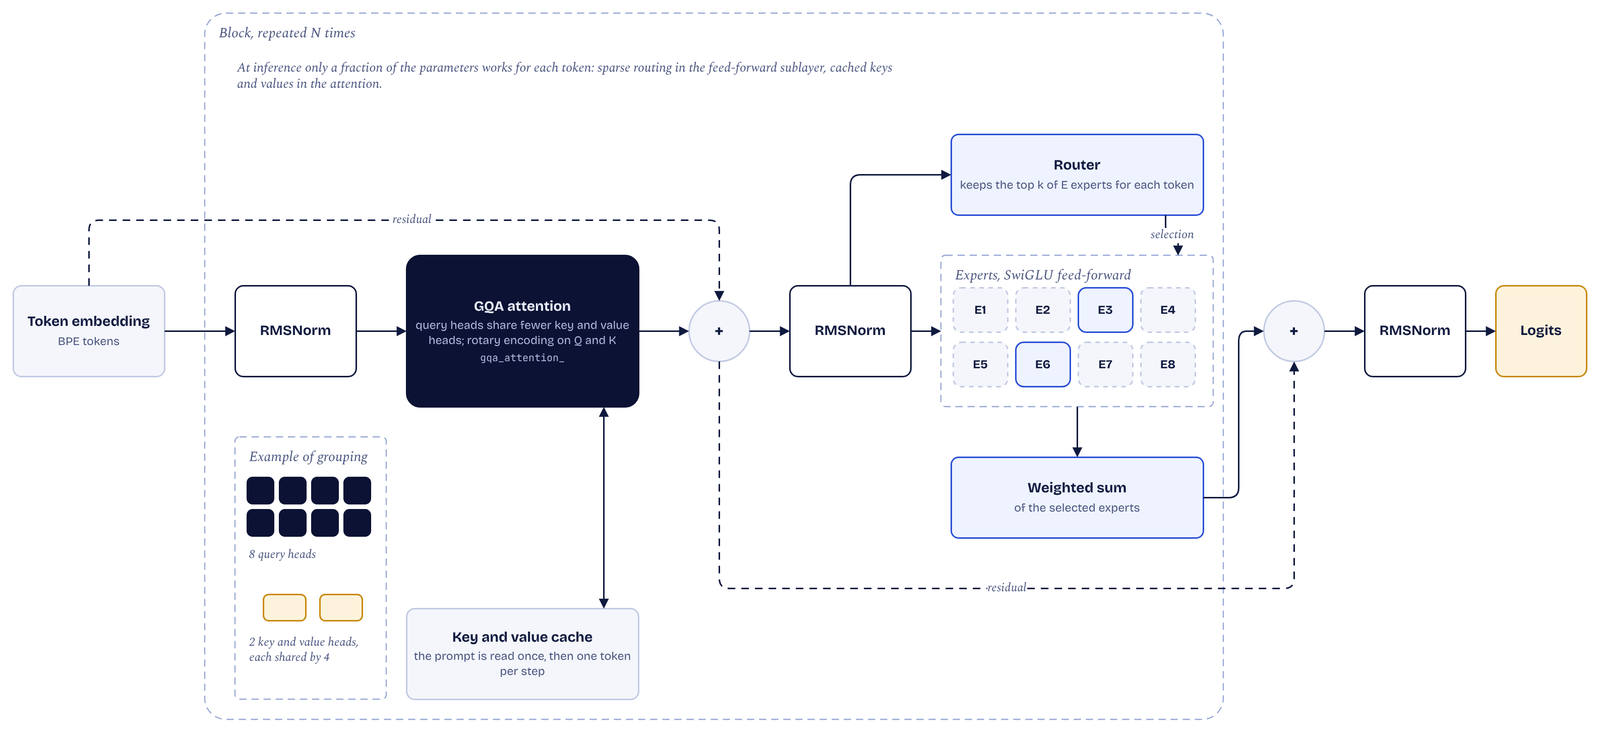
Modelos de pesos abiertos, importados y verificados
La importación lee un modelo publicado en seis etapas y produce un tipo de red Dlib con su tokenizador. Cada posición de un prompt de prueba se compara después con el motor dinámico y con una implementación de referencia externa: un modelo importado calcula lo que su editor publicó.

Memoria y dispositivos, gestionados por debajo de la red
Dos mecanismos actúan bajo las capas, sin cambiar una red ni un bucle de entrenamiento. V²RAM decide dónde reside cada bloque de tensores, dentro de un presupuesto menor que el modelo. El encaminamiento cronometra cada operación en el anfitrión, en la NPU y en la GPU integrada, y conserva el más rápido.
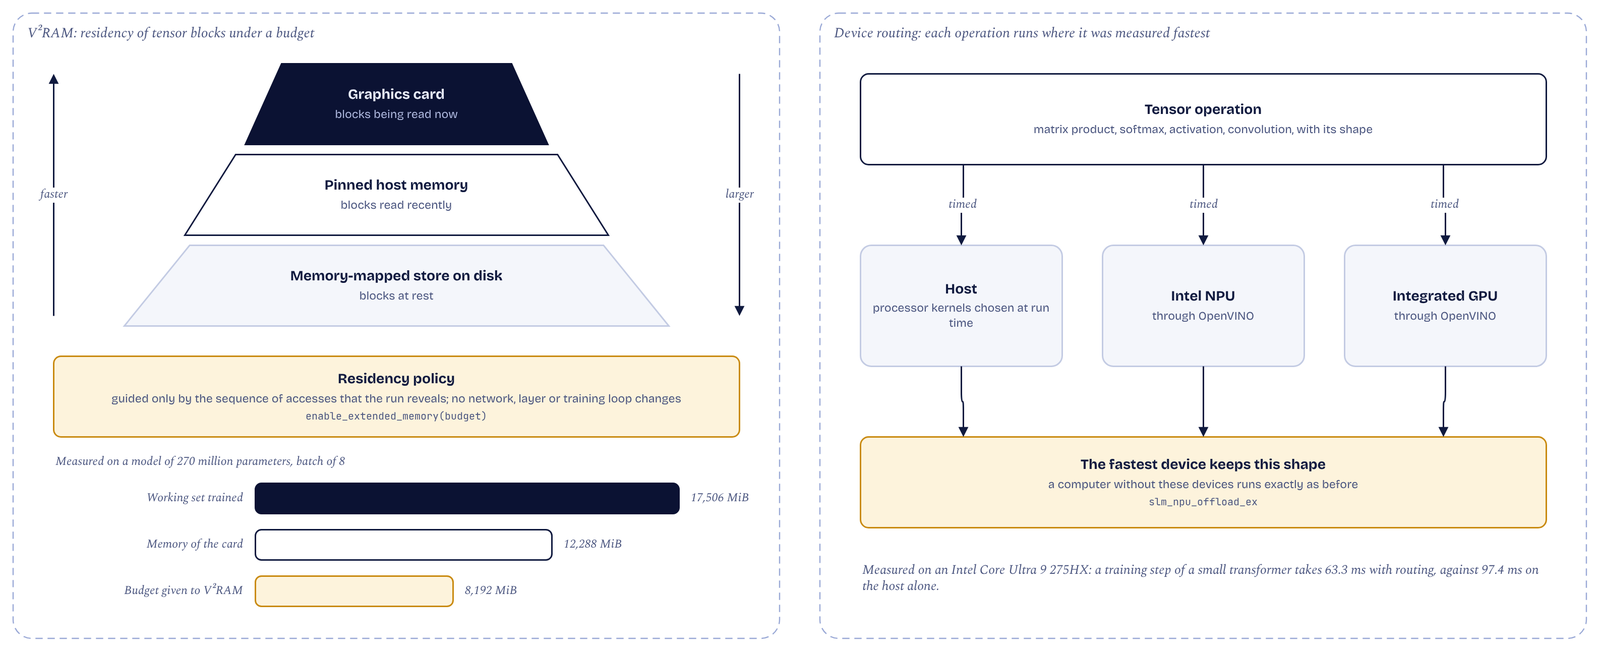
24 ejemplos, uno por mecanismo
Cada mecanismo de la biblioteca viene con un programa que lo construye, lo ejecuta y lo valida: una documentación que se mantiene siempre al día.
Primeros modelos
Un modelo a nivel de carácter y después el transformer canónico, entrenado hasta reproducir su corpus byte a byte.
slm_basic_train_ex slm_advanced_train_ex slm_enwiki_train_ex
Variantes de atención y de propagación
Atención de consultas agrupadas, tiempo de cómputo adaptativo, la capa de atención fusionada con su caché de claves y valores, mezcla de expertos.
slm_advanced_gqa_train_ex slm_advanced_gqa_kvc_train_ex slm_transformer_configs_ex
La serie Cygnus
El preentrenamiento de base con un corpus, y después el ajuste por instrucciones y una conversación interactiva.
slm_cygnus_foundation_ex slm_cygnus_instruct_ex
Modelos de pesos abiertos
Importación GGUF y motor dinámico, ajuste fino con LoRA y DoRA con su validación numérica, destilación, embeddings y búsqueda documental.
slm_gguf_import_ex slm_gguf_runtime_ex slm_lora_finetune_ex slm_lora_adapter_check_ex slm_distill_ex slm_embed_ex
Visión
La torre de visión de un modelo multimodal, un clasificador entrenado desde cero con CIFAR-10, un entrenamiento autosupervisado con Barlow Twins.
slm_vision_tower_ex slm_vit_classify_ex slm_vit_ssl_ex
Memoria y dispositivos
Una red mayor que la tarjeta gráfica, y operaciones encaminadas a la NPU y a la GPU integrada.
slm_extended_memory_ex slm_npu_offload_ex
Razonamiento y aplicaciones
Razonamiento jerárquico con Sudoku-Extreme y ARC-AGI, anonimización de documentos, compresión sin pérdida por predicción.
slm_hrm_sudoku_ex slm_hrm_arc_puzzle_ex slm_document_anonymizer_ex slm_predictive_compressor_ex slm_tok_predictive_compressor_ex
Trabajos en curso para ampliar las capacidades de la biblioteca
- QLoRA
- Mantener la base congelada cuantizada en memoria durante el ajuste fino.
- Optimización por preferencias
- DPO con la referencia congelada obtenida de la misma red, con sus adaptadores neutralizados.
- Mezcla de expertos en el camino estático
- Hacer estos modelos entrenables y convertibles como los demás.
- Un modelo propio de la biblioteca
- Un pequeño modelo de lenguaje con una topología y un vocabulario elegidos aquí.
Utilice la biblioteca, o contribuya a su desarrollo
El código es público, bajo una licencia permisiva. Las contribuciones, el patrocinio y las colaboraciones hacen avanzar la biblioteca.