
Kompression durch Vorhersage
Ein Sprachmodell ist eine Wahrscheinlichkeit für das, was als Nächstes kommt, und ein arithmetischer Kodierer macht aus einer Wahrscheinlichkeit Bits. Je besser die Vorhersage, desto kürzer die Datei. Ein Beispielprogramm der Bibliothek baut die ganze Kette und misst sie.
- 0,937
- Bit pro Byte auf einem Gigabyte Wikipedia-Text
- 7,9 Mio.
- Parameter im vorhersagenden Netz
- 107
- Kontextmodelle, die seine Vorhersage korrigieren
- 1
- Quelldatei für Kompressor und Dekompressor
Ein Modell, das gut vorhersagt, komprimiert gut
Ein Symbol zu kodieren kostet den Logarithmus der Wahrscheinlichkeit, die das Modell ihm gegeben hat: Die Länge des Archivs ist die Kreuzentropie des Modells auf den Daten. Ein Netz auf das nächste Token zu trainieren und einen Text zu komprimieren ist daher dasselbe Problem, und die Größe des Archivs wird zu einem ehrlichen Maß dessen, was das Netz gelernt hat.
Zwei Programme, von Bytes zu Tokens
Byte für Byte, für jede Datei
Ein kleiner Transformer sagt das nächste Byte einer beliebigen Datei vorher. Ein Bit gibt an, ob er recht hatte, die Fehler werden vollständig geschrieben, und das Modell kann im Archiv mitreisen, das sich dann von selbst entpackt.
slm_predictive_compressor_ex.cpp
Token für Token, für Text
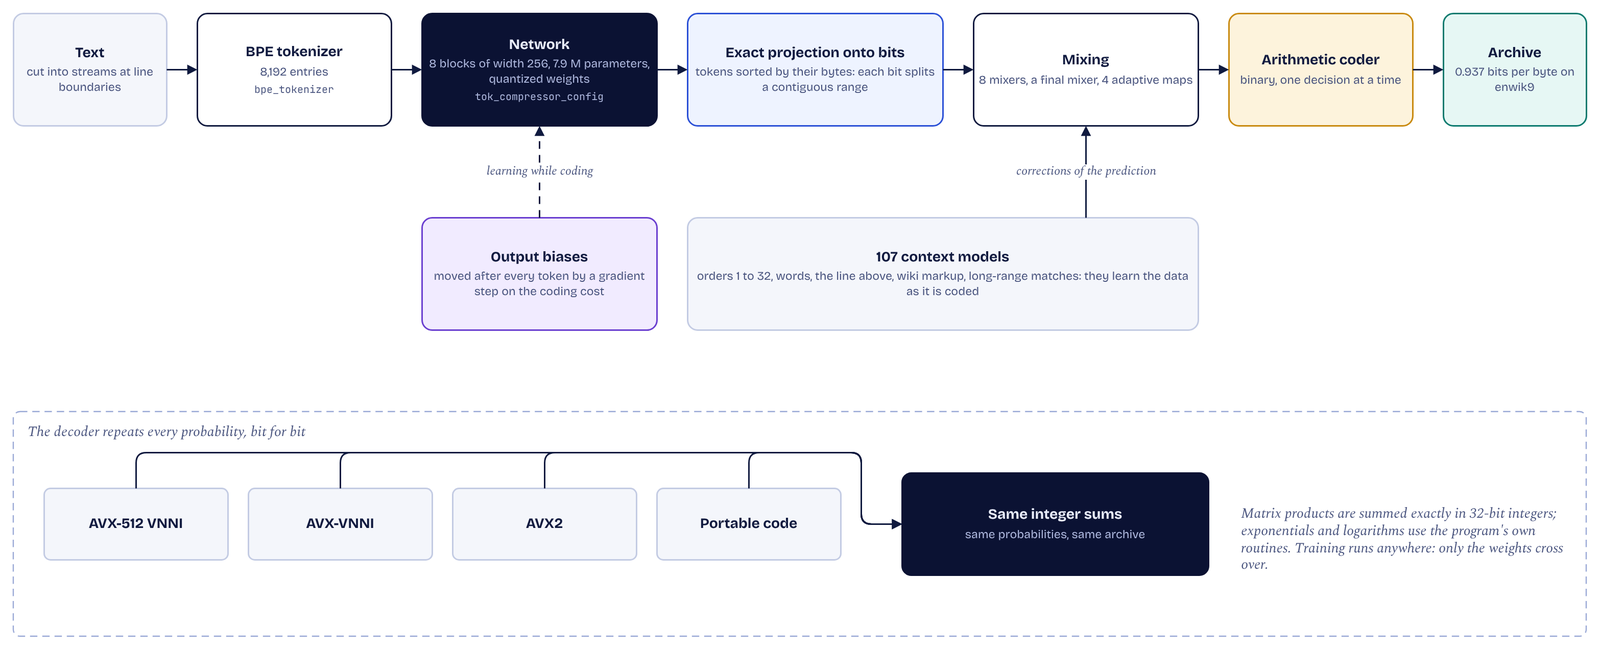
Ein Decoder aus acht Blöcken sagt Tokens vorher, Kontextmodelle lernen den Text während des Kodierens, und beides wird mit dem Tokenizer in das Programm kompiliert. Das ist die unten gemessene Version.
slm_tok_predictive_compressor_ex.cpp
Vom Token zu den Bits
- Das Netz gibt jedem der 8.192 Tokens des Vokabulars eine Wahrscheinlichkeit.
- Die Tokens sind nach ihren Bytes geordnet: Jedes Bit des nächsten Bytes teilt einen zusammenhängenden Bereich, und die Wahrscheinlichkeit eines Bits wird exakt berechnet, ohne Näherung.
- 107 Kontextmodelle führen eine Historie der bereits kodierten Bits, vom letzten Byte bis zu Übereinstimmungen weit zurück im Text.
- Acht Mischer, ein abschließender Mischer und vier adaptive Tabellen kombinieren diese Vorhersagen, Entscheidung für Entscheidung.
- Ein binärer arithmetischer Kodierer schreibt das Ergebnis. Währenddessen bewegen sich die Ausgabe-Biases des Netzes nach jedem Token, und der Dekodierer macht dieselben Schritte.
Dieselben Bits auf jeder Maschine
Ein Dekodierer muss jede Wahrscheinlichkeit des Kodierers wiederfinden, bis zum letzten Bit, sonst dekodiert er etwas anderes. Gleitkommaergebnisse ändern sich aber mit dem Prozessor, der Bibliothek und der Reihenfolge der Summen. Der Kodierpfad hat deshalb eine eigene Arithmetik.
- Matrixprodukte laufen auf Ganzzahlen und werden exakt in 32 Bit summiert: Eine Ganzzahlsumme hängt nicht von ihrer Reihenfolge ab.
- Exponentialfunktionen, Logarithmen und Rotationen nutzen eigene Routinen des Programms, aufgebaut auf den grundlegenden IEEE-Operationen.
- Die Kernel für AVX-512 VNNI, AVX-VNNI und AVX2 schreiben dasselbe Archiv wie der portable Code.
- Das Training läuft auf beliebiger Hardware, auch auf einer Grafikkarte: Nur die Gewichte wechseln die Seite.
Gemessen auf einem Gigabyte Wikipedia
Das Programm hat enwik9 mit dem Netz des Repositorys und seinen Standardoptionen komprimiert und dekomprimiert, auf einem Kern eines Intel Core Ultra 9 275HX. Die dekomprimierte Datei ist Byte für Byte mit der Eingabe identisch.
| Archiv | 117.169.624 Bytes |
|---|---|
| Bit pro Byte | 0,937 |
| Dekompressor, Tokenizer und Netz inbegriffen | 7.063.888 Bytes |
| Zeit pro Richtung, ein Kern | Etwa 25 Stunden |
| Kompression mit den vom Prozessor gewählten Kernen | 24 h 48 min statt 30 h 18 min |
Der Lieferumfang eines Archivs
Der Tokenizer und die auf 6 Bit quantisierten Gewichte sind als Daten in das Programm kompiliert. Derselbe Quelltext ergibt einen reinen Dekompressor, etwa 320 KB Code neben seinen Daten, mit einem Compileraufruf und ohne zu installierende Bibliothek.
Lehren aus dem Beispiel, über die Kompression hinaus
Bit pro Byte macht das Ziel des nächsten Tokens zu einer Größe, die jeder nachprüfen kann. Und das Verfahren gilt immer dann, wenn ein trainiertes Netz auf zwei Maschinen identische Ergebnisse liefern muss: überall trainieren, die Gewichte als Daten ausliefern und die Inferenz in einer Arithmetik ausführen, in der jede Operation festgelegt ist.
Komprimieren Sie Ihre eigenen Dateien
Das Repository liefert ein bereits trainiertes Netz: Einmal kompiliert, komprimiert das Programm sofort.