
Compression par prédiction
Un modèle de langage est une probabilité sur ce qui vient ensuite, et un codeur arithmétique transforme une probabilité en bits. Meilleure est la prédiction, plus court est le fichier. Un programme d'exemple de la bibliothèque construit toute la chaîne et la mesure.
- 0,937
- bit par octet sur un gigaoctet de texte de Wikipédia
- 7,9 M
- de paramètres dans le réseau qui prédit
- 107
- modèles de contexte qui corrigent sa prédiction
- 1
- fichier source pour le compresseur et le décompresseur
Un modèle qui prédit bien compresse bien
Coder un symbole coûte le logarithme de la probabilité que le modèle lui a donnée : la longueur de l'archive est l'entropie croisée du modèle sur les données. Entraîner un réseau à prédire le token suivant et compresser un texte sont donc un seul et même problème, et la taille de l'archive devient une mesure honnête de ce que le réseau a appris.
Deux programmes, des octets aux tokens
Octet par octet, pour tout fichier
Un petit transformer prédit l'octet suivant de n'importe quel fichier. Un bit indique s'il avait raison, les erreurs sont écrites en entier, et le modèle peut voyager dans l'archive, qui se décompresse alors seule.
slm_predictive_compressor_ex.cpp
Token par token, pour le texte
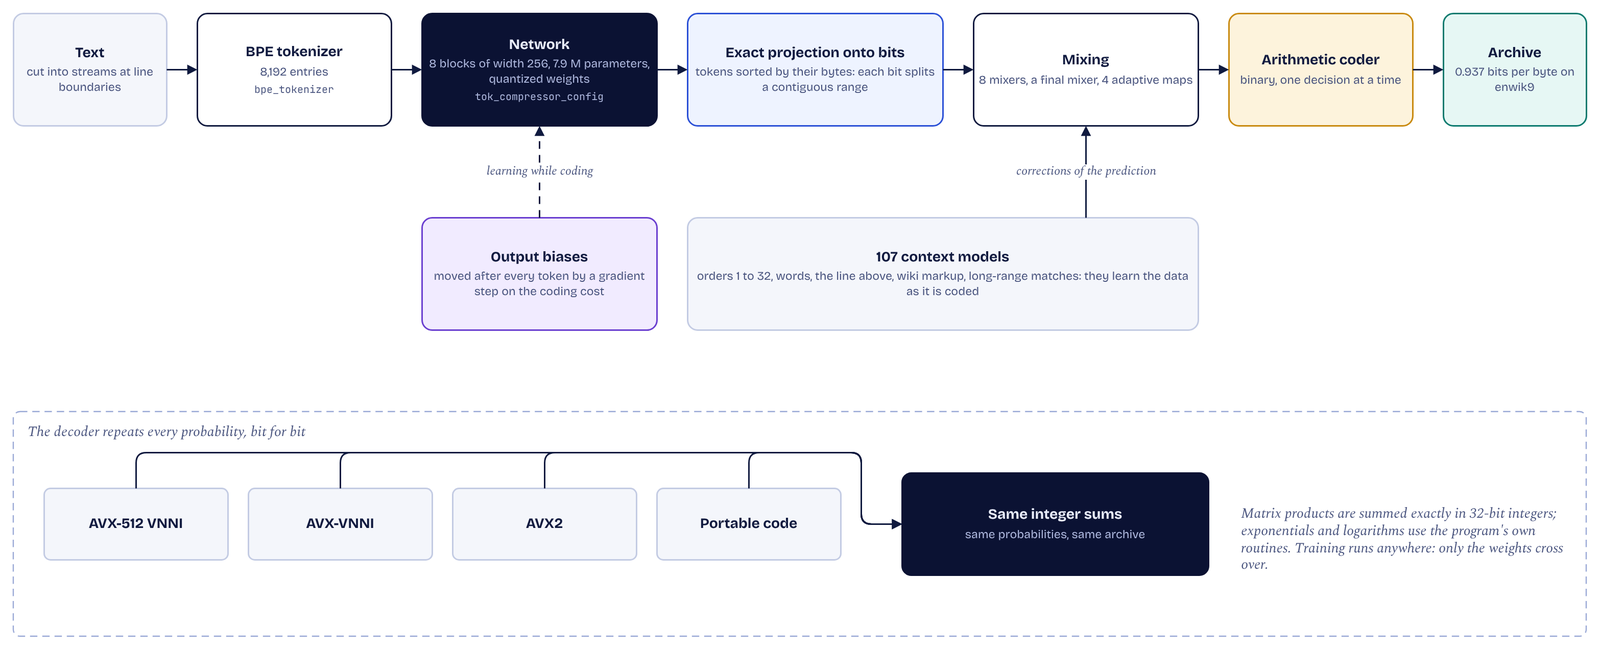
Un décodeur de huit blocs prédit des tokens, des modèles de contexte apprennent le texte au fil du codage, et l'ensemble est compilé dans le programme avec le tokenizer. C'est la version mesurée ci-dessous.
slm_tok_predictive_compressor_ex.cpp
Du token aux bits
- Le réseau donne une probabilité à chacun des 8 192 tokens du vocabulaire.
- Les tokens sont rangés dans l'ordre de leurs octets : chaque bit de l'octet suivant coupe une plage contiguë en deux, et la probabilité d'un bit se calcule exactement, sans approximation.
- 107 modèles de contexte gardent l'historique des bits déjà codés, du dernier octet jusqu'aux correspondances trouvées loin en arrière dans le texte.
- Huit mélangeurs, un mélangeur final et quatre tables adaptatives combinent ces prédictions, décision par décision.
- Un codeur arithmétique binaire écrit le résultat. Pendant ce temps, les biais de sortie du réseau bougent après chaque token, et le décodeur fait les mêmes pas.
Les mêmes bits sur toutes les machines
Un décodeur doit retrouver chaque probabilité utilisée par l'encodeur, au dernier bit près, sans quoi il décode autre chose. Or les résultats en virgule flottante changent avec le processeur, la bibliothèque et l'ordre des sommes. Le chemin de codage a donc sa propre arithmétique.
- Les produits matriciels se font sur des entiers et sont sommés exactement sur 32 bits : une somme d'entiers ne dépend pas de son ordre.
- Exponentielles, logarithmes et rotations passent par les routines du programme, construites sur les opérations IEEE de base.
- Les noyaux AVX-512 VNNI, AVX-VNNI et AVX2 écrivent la même archive que le code portable.
- L'entraînement tourne sur n'importe quel matériel, carte graphique comprise : seuls les poids passent d'un côté à l'autre.
Mesuré sur un gigaoctet de Wikipédia
Le programme a compressé puis décompressé enwik9 avec le réseau du dépôt et ses options par défaut, sur un cœur d'un Intel Core Ultra 9 275HX. Le fichier décompressé est identique à l'entrée, octet pour octet.
| Archive | 117 169 624 octets |
|---|---|
| Bits par octet | 0,937 |
| Décompresseur, tokeniseur et réseau compris | 7 063 888 octets |
| Temps par sens, un cœur | Environ 25 heures |
| Compression avec les noyaux choisis par le processeur | 24 h 48 min au lieu de 30 h 18 min |
Le contenu livré avec une archive
Le tokenizer et les poids, quantifiés sur 6 bits, sont compilés dans le programme comme des données. Le même source produit un décompresseur seul, environ 320 Ko de code à côté de ses données, en une commande de compilation et sans bibliothèque à installer.
Les enseignements de l'exemple, au-delà de la compression
Le bit par octet transforme l'objectif du token suivant en une grandeur que chacun peut vérifier. Et la méthode vaut chaque fois qu'un réseau entraîné doit donner des résultats identiques sur deux machines : entraîner n'importe où, livrer les poids comme des données, et exécuter l'inférence dans une arithmétique dont chaque opération est fixée.
Compressez vos propres fichiers
Le dépôt fournit un réseau déjà entraîné : une fois compilé, le programme compresse immédiatement.