
Compressione per predizione
Un modello linguistico è una probabilità su ciò che viene dopo, e un codificatore aritmetico trasforma una probabilità in bit. Migliore è la predizione, più corto è il file. Un programma di esempio della libreria costruisce l'intera catena e la misura.
- 0,937
- bit per byte su un gigabyte di testo di Wikipedia
- 7,9 M
- di parametri nella rete che predice
- 107
- modelli di contesto che correggono la sua predizione
- 1
- file sorgente per il compressore e il decompressore
Un modello che predice bene comprime bene
Codificare un simbolo costa il logaritmo della probabilità che il modello gli ha dato: la lunghezza dell'archivio è l'entropia incrociata del modello sui dati. Addestrare una rete a predire il token successivo e comprimere un testo sono quindi lo stesso problema, e la dimensione dell'archivio diventa una misura onesta di ciò che la rete ha imparato.
Due programmi, dai byte ai token
Byte per byte, per qualunque file
Un piccolo transformer predice il byte successivo di qualunque file. Un bit dice se aveva ragione, gli errori sono scritti per intero, e il modello può viaggiare dentro l'archivio, che allora si decomprime da solo.
slm_predictive_compressor_ex.cpp
Token per token, per il testo
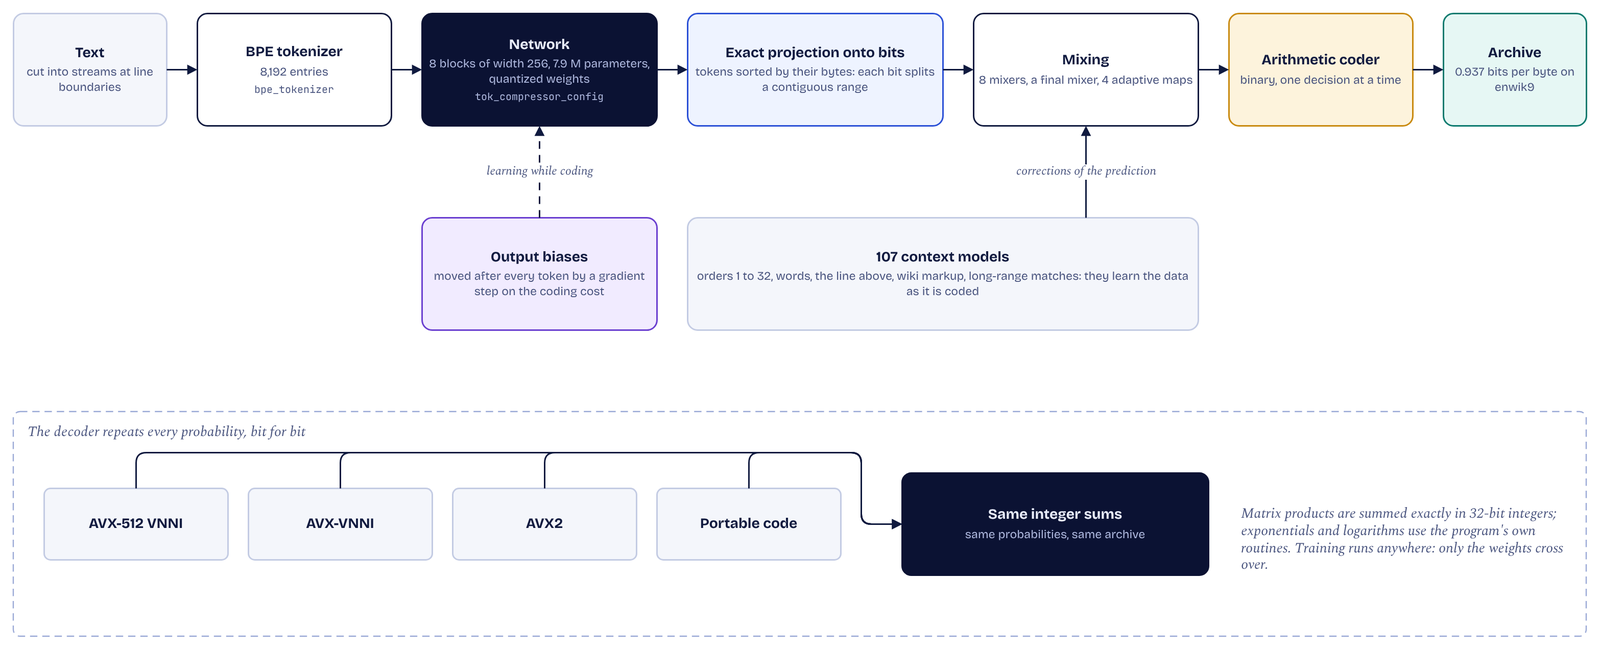
Un decoder di otto blocchi predice token, i modelli di contesto imparano il testo durante la codifica, ed entrambi sono compilati nel programma con il tokenizer. È la versione misurata qui sotto.
slm_tok_predictive_compressor_ex.cpp
Dal token ai bit
- La rete dà una probabilità a ciascuno degli 8.192 token del vocabolario.
- I token sono tenuti nell'ordine dei loro byte: ogni bit del byte successivo divide un intervallo contiguo, e la probabilità di un bit si calcola esattamente, senza approssimazione.
- 107 modelli di contesto conservano la storia dei bit già codificati, dall'ultimo byte fino alle corrispondenze trovate molto indietro nel testo.
- Otto miscelatori, un miscelatore finale e quattro mappe adattive combinano queste predizioni, decisione per decisione.
- Un codificatore aritmetico binario scrive il risultato. Intanto i bias di uscita della rete si spostano dopo ogni token, e il decodificatore compie gli stessi passi.
Gli stessi bit su ogni macchina
Un decodificatore deve ritrovare ogni probabilità usata dal codificatore, fino all'ultimo bit, altrimenti decodifica altro. I risultati in virgola mobile cambiano però con il processore, la libreria e l'ordine delle somme. Il percorso di codifica ha quindi un'aritmetica propria.
- I prodotti matriciali lavorano su interi e sono sommati esattamente su 32 bit: una somma di interi non dipende dal suo ordine.
- Esponenziali, logaritmi e rotazioni usano le routine del programma, costruite sulle operazioni IEEE di base.
- I kernel AVX-512 VNNI, AVX-VNNI e AVX2 scrivono lo stesso archivio del codice portabile.
- L'addestramento gira su qualunque hardware, scheda grafica compresa: solo i pesi passano da una parte all'altra.
Misurato su un gigabyte di Wikipedia
Il programma ha compresso e decompresso enwik9 con la rete del repository e le opzioni predefinite, su un core di un Intel Core Ultra 9 275HX. Il file decompresso è identico all'ingresso, byte per byte.
| Archivio | 117.169.624 byte |
|---|---|
| Bit per byte | 0,937 |
| Decompressore, tokenizer e rete compresi | 7.063.888 byte |
| Tempo per direzione, un core | Circa 25 ore |
| Compressione con i nuclei scelti dal processore | 24 h 48 min invece di 30 h 18 min |
Il contenuto fornito con un archivio
Il tokenizer e i pesi, quantizzati a 6 bit, sono compilati nel programma come dati. Lo stesso sorgente produce un decompressore da solo, circa 320 KB di codice accanto ai suoi dati, con un solo comando di compilazione e senza librerie da installare.
Gli insegnamenti dell'esempio, oltre la compressione
Il bit per byte trasforma l'obiettivo del token successivo in una grandezza che chiunque può verificare. E il metodo vale ogni volta che una rete addestrata deve dare risultati identici su due macchine: addestrare ovunque, consegnare i pesi come dati, ed eseguire l'inferenza in un'aritmetica in cui ogni operazione è fissata.
Comprimete i vostri file
Il repository fornisce una rete già addestrata: una volta compilato, il programma comprime subito.