
预测式压缩
语言模型给出“接下来是什么”的概率,算术编码器把概率变成比特。预测越准,文件越短。核心库的一个示例程序构建了整条链并对其进行测量。
- 0.937
- 每字节比特数,基于 1 GB 维基百科文本
- 7.9 M
- 负责预测的网络的参数量
- 107
- 个上下文模型修正它的预测
- 1
- 个源文件同时提供压缩器和解压器
预测得好的模型,压缩得也好
编码一个符号的代价,是模型赋予它的概率的对数:归档的长度就是模型在数据上的交叉熵。因此,训练网络预测下一个词元与压缩一段文本是同一个问题,归档的大小也就成了衡量网络学到多少的一把诚实的尺子。
两个程序,从字节到词元
逐字节,适用于任何文件
一个小型 transformer 预测任意文件的下一个字节。用一个比特表示它是否猜对,猜错的字节原样写入;模型可以随归档一起传送,这样归档就能自行解压。
slm_predictive_compressor_ex.cpp
逐词元,适用于文本
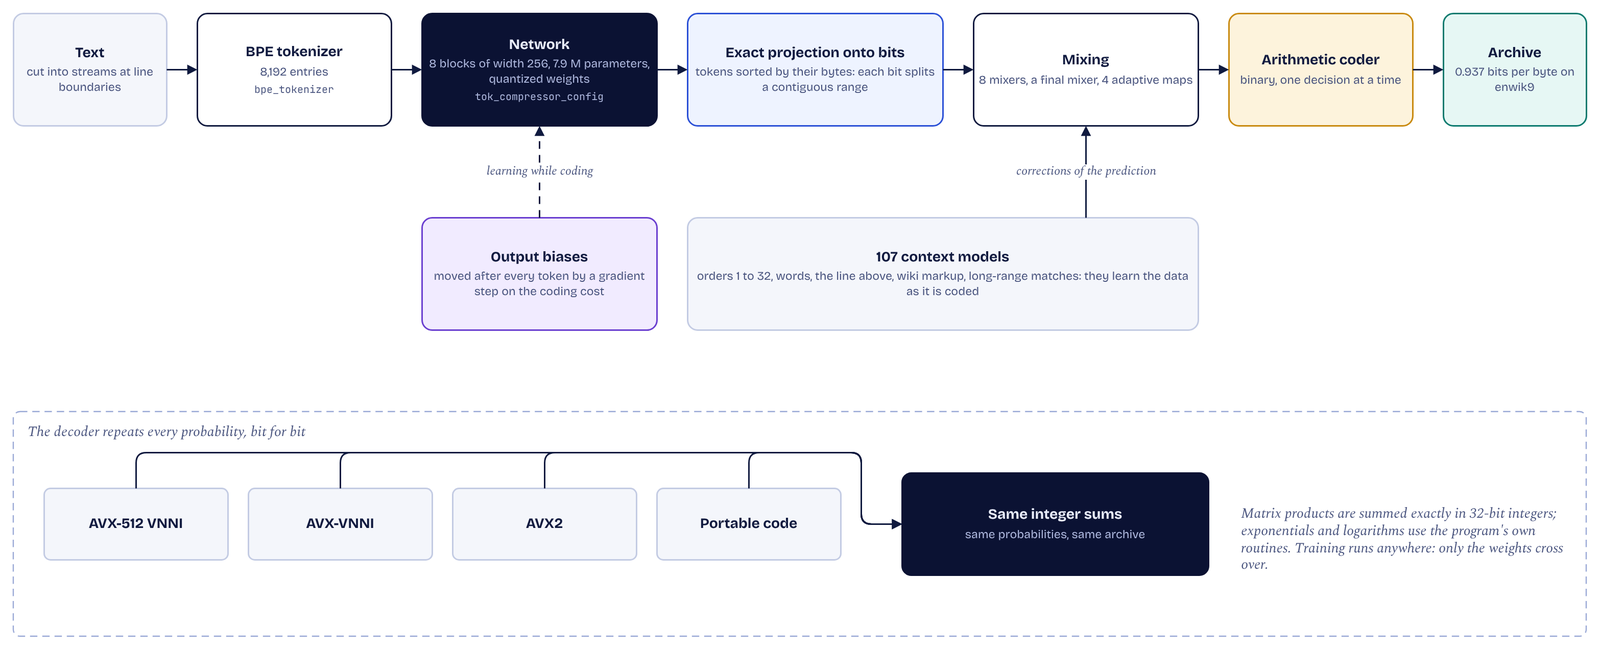
一个八个模块的解码器预测词元,上下文模型在编码过程中学习文本,两者连同分词器一起编译进程序。下面测量的就是这个版本。
slm_tok_predictive_compressor_ex.cpp
从词元到比特
- 网络为词表中的 8,192 个词元各给出一个概率。
- 词元按其字节的顺序排列:下一个字节的每个比特都把一个连续区间一分为二,因此每个比特的概率可以精确算出,没有任何近似。
- 107 个上下文模型记录已编码比特的历史,从上一个字节直到文本中很远处找到的匹配。
- 八个混合器、一个最终混合器和四个自适应映射逐个决策地组合这些预测。
- 二进制算术编码器写出结果。与此同时,网络的输出偏置在每个词元之后都会移动,解码器也走完全相同的步骤。
每台机器上都是相同的比特
解码器必须得到编码器用过的每一个概率,精确到最后一个比特,否则解出来的就是别的东西。而浮点结果会随处理器、函数库和求和顺序而变化。因此,编码路径有一套自己的算术。
- 矩阵乘积在整数上进行,并以 32 位精确求和:整数求和与顺序无关。
- 指数、对数和旋转使用程序自带的例程,它们由基本的 IEEE 运算构建而成。
- AVX-512 VNNI、AVX-VNNI 和 AVX2 的内核写出的归档与可移植代码完全相同。
- 训练可以在任何硬件上进行,包括显卡:只有权重跨到编码这一侧。
在 1 GB 维基百科文本上的实测
程序使用仓库中的网络和默认选项,在 Intel Core Ultra 9 275HX 的单个核心上压缩并解压了 enwik9。解压后的文件与输入逐字节相同。
| 归档 | 117,169,624 字节 |
|---|---|
| 每字节比特数 | 0.937 |
| 解压程序,含分词器和网络 | 7,063,888 字节 |
| 单向耗时,单核 | 约 25 小时 |
| 使用处理器所选内核进行压缩 | 24 小时 48 分,而不是 30 小时 18 分 |
随归档一同交付的内容
分词器和量化到 6 位的权重作为数据编译进程序。同一份源代码还能单独构建出解压器,除数据外代码约 320 KB,只需一条编译命令,无需安装任何库。
这个示例在压缩之外的启示
每字节比特数把“预测下一个词元”这一目标变成了任何人都能核验的量。而且,只要训练好的网络必须在两台机器上给出完全相同的结果,这套方法都适用:在任何地方训练,把权重作为数据交付,并用每个运算都固定下来的算术执行推理。