
Compresión por predicción
Un modelo de lenguaje es una probabilidad sobre lo que viene después, y un codificador aritmético convierte una probabilidad en bits. Cuanto mejor es la predicción, más corto es el archivo. Un programa de ejemplo de la biblioteca construye toda la cadena y la mide.
- 0,937
- bit por byte en un gigabyte de texto de Wikipedia
- 7,9 M
- de parámetros en la red que predice
- 107
- modelos de contexto que corrigen su predicción
- 1
- archivo fuente para el compresor y el descompresor
Un modelo que predice bien comprime bien
Codificar un símbolo cuesta el logaritmo de la probabilidad que el modelo le dio: la longitud del archivo comprimido es la entropía cruzada del modelo sobre los datos. Entrenar una red para predecir el token siguiente y comprimir un texto son, por tanto, el mismo problema, y el tamaño del archivo comprimido se convierte en una medida honesta de lo que la red ha aprendido.
Dos programas, de los bytes a los tokens
Byte a byte, para cualquier archivo
Un transformer pequeño predice el byte siguiente de cualquier archivo. Un bit indica si acertó, los fallos se escriben completos, y el modelo puede viajar dentro del archivo comprimido, que entonces se descomprime por sí solo.
slm_predictive_compressor_ex.cpp
Token a token, para el texto
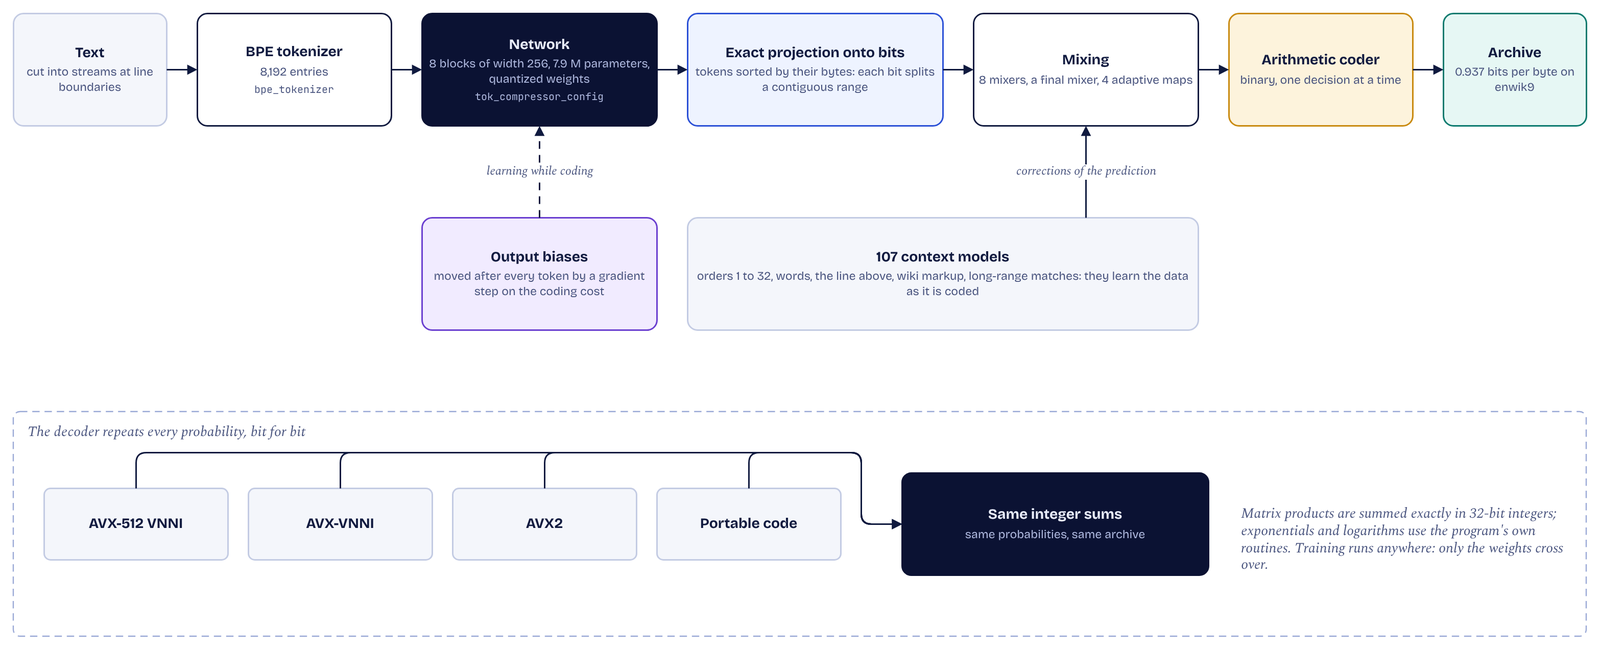
Un decodificador de ocho bloques predice tokens, los modelos de contexto aprenden el texto mientras se codifica, y ambos se compilan en el programa con el tokenizer. Es la versión medida más abajo.
slm_tok_predictive_compressor_ex.cpp
Del token a los bits
- La red da una probabilidad a cada uno de los 8192 tokens del vocabulario.
- Los tokens se guardan en el orden de sus bytes: cada bit del byte siguiente divide un rango contiguo, y la probabilidad de un bit se calcula exactamente, sin aproximación.
- 107 modelos de contexto guardan el historial de los bits ya codificados, desde el último byte hasta coincidencias encontradas muy atrás en el texto.
- Ocho mezcladores, un mezclador final y cuatro mapas adaptativos combinan estas predicciones, decisión por decisión.
- Un codificador aritmético binario escribe el resultado. Mientras tanto, los sesgos de salida de la red se mueven después de cada token, y el decodificador da los mismos pasos.
Los mismos bits en todas las máquinas
Un decodificador debe reencontrar cada probabilidad que usó el codificador, hasta el último bit, o decodifica otra cosa. Pero los resultados en coma flotante cambian con el procesador, la biblioteca y el orden de las sumas. El camino de codificación tiene por eso una aritmética propia.
- Los productos matriciales trabajan con enteros y se suman exactamente en 32 bits: una suma de enteros no depende de su orden.
- Exponenciales, logaritmos y rotaciones usan las rutinas del propio programa, construidas sobre las operaciones IEEE básicas.
- Los núcleos AVX-512 VNNI, AVX-VNNI y AVX2 escriben el mismo archivo que el código portable.
- El entrenamiento funciona en cualquier hardware, tarjeta gráfica incluida: solo los pesos pasan de un lado a otro.
Medido en un gigabyte de Wikipedia
El programa comprimió y descomprimió enwik9 con la red del repositorio y sus opciones por defecto, en un núcleo de un Intel Core Ultra 9 275HX. El archivo descomprimido es idéntico a la entrada, byte por byte.
| Archivo comprimido | 117 169 624 bytes |
|---|---|
| Bits por byte | 0,937 |
| Descompresor, tokenizador y red incluidos | 7 063 888 bytes |
| Tiempo por sentido, un núcleo | Unas 25 horas |
| Compresión con los núcleos elegidos por el procesador | 24 h 48 min en lugar de 30 h 18 min |
El contenido que acompaña a un archivo comprimido
El tokenizer y los pesos, cuantizados a 6 bits, se compilan en el programa como datos. El mismo código fuente produce un descompresor solo, unos 320 KB de código junto a sus datos, con una única orden de compilación y sin bibliotecas que instalar.
Las enseñanzas del ejemplo, más allá de la compresión
El bit por byte convierte el objetivo del token siguiente en una magnitud que cualquiera puede comprobar. Y el método sirve siempre que una red entrenada deba dar resultados idénticos en dos máquinas: entrenar en cualquier parte, entregar los pesos como datos y ejecutar la inferencia en una aritmética en la que cada operación está fijada.
Comprima sus propios archivos
El repositorio incluye una red ya entrenada: una vez compilado, el programa comprime de inmediato.