
पूर्वानुमान से संपीड़न
भाषा मॉडल इस बात की प्रायिकता है कि आगे क्या आएगा, और अरिथमेटिक कोडर प्रायिकता को बिट में बदल देता है। पूर्वानुमान जितना अच्छा, फ़ाइल उतनी छोटी। लाइब्रेरी का एक उदाहरण प्रोग्राम पूरी शृंखला बनाता और उसे मापता है।
- 0.937
- बिट प्रति बाइट, Wikipedia के एक गीगाबाइट पाठ पर
- 7.9 M
- पूर्वानुमान करने वाले नेटवर्क के पैरामीटर
- 107
- कॉन्टेक्स्ट मॉडल जो उसके पूर्वानुमान को सुधारते हैं
- 1
- सोर्स फ़ाइल, कंप्रेसर और डीकंप्रेसर दोनों के लिए
जो मॉडल अच्छा पूर्वानुमान करता है, वह अच्छा संपीड़न करता है
किसी प्रतीक को कोड करने की लागत उस प्रायिकता का लघुगणक है जो मॉडल ने उसे दी: आर्काइव की लंबाई, डेटा पर मॉडल की क्रॉस-एन्ट्रॉपी है। इसलिए किसी नेटवर्क को अगला टोकन बताने के लिए प्रशिक्षित करना और किसी पाठ को संपीड़ित करना एक ही समस्या है, और आर्काइव का आकार इस बात का ईमानदार पैमाना बन जाता है कि नेटवर्क ने क्या सीखा।
दो प्रोग्राम, बाइट से टोकन तक
बाइट-दर-बाइट, किसी भी फ़ाइल के लिए
एक छोटा ट्रांसफ़ॉर्मर किसी भी फ़ाइल के अगले बाइट का पूर्वानुमान करता है। एक बिट बताता है कि वह सही था या नहीं, चूके हुए बाइट पूरे लिखे जाते हैं, और मॉडल आर्काइव के भीतर साथ जा सकता है, जो तब अपने आप डीकंप्रेस हो जाता है।
slm_predictive_compressor_ex.cpp
टोकन-दर-टोकन, पाठ के लिए
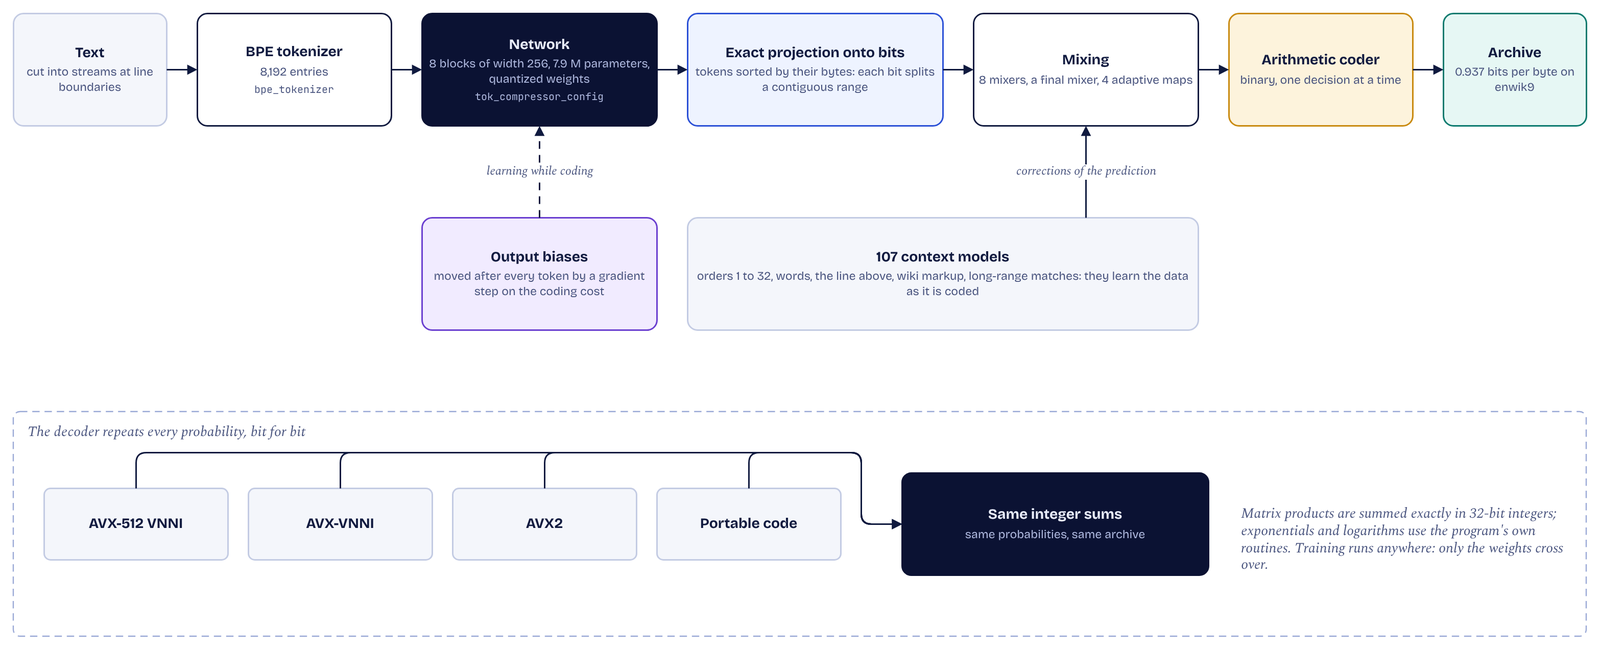
आठ ब्लॉक का एक डिकोडर टोकन का पूर्वानुमान करता है, कॉन्टेक्स्ट मॉडल कोडिंग के साथ-साथ पाठ सीखते हैं, और दोनों टोकनाइज़र के साथ प्रोग्राम में कंपाइल होते हैं। नीचे इसी संस्करण को मापा गया है।
slm_tok_predictive_compressor_ex.cpp
टोकन से बिट तक
- नेटवर्क शब्दावली के 8,192 टोकन में से हर एक को एक प्रायिकता देता है।
- टोकन अपने बाइट के क्रम में रखे जाते हैं: अगले बाइट का हर बिट एक सतत सीमा को दो भागों में बाँटता है, और बिट की प्रायिकता बिना किसी सन्निकटन के ठीक-ठीक निकलती है।
- 107 कॉन्टेक्स्ट मॉडल पहले से कोड किए गए बिट का इतिहास रखते हैं, पिछले बाइट से लेकर पाठ में बहुत पीछे मिले मेल तक।
- आठ मिक्सर, एक अंतिम मिक्सर और चार अनुकूली मैप इन पूर्वानुमानों को निर्णय-दर-निर्णय मिलाते हैं।
- एक बाइनरी अरिथमेटिक कोडर परिणाम लिखता है। इसी बीच नेटवर्क के आउटपुट बायस हर टोकन के बाद खिसकते हैं, और डिकोडर भी वही क़दम उठाता है।
हर मशीन पर वही बिट
डिकोडर को वह हर प्रायिकता पानी होती है जो एनकोडर ने इस्तेमाल की, आख़िरी बिट तक, वरना वह कुछ और डिकोड करता है। पर फ़्लोटिंग-पॉइंट के नतीजे प्रोसेसर, लाइब्रेरी और जोड़ के क्रम के साथ बदलते हैं। इसलिए कोडिंग पथ की अपनी अलग गणना है।
- मैट्रिक्स गुणन इंटीजर पर चलते हैं और 32 बिट में ठीक-ठीक जोड़े जाते हैं: इंटीजर का जोड़ अपने क्रम पर निर्भर नहीं करता।
- एक्सपोनेंशियल, लघुगणक और रोटेशन प्रोग्राम की अपनी रूटीन से निकलते हैं, जो मूल IEEE ऑपरेशन से बनी हैं।
- AVX-512 VNNI, AVX-VNNI और AVX2 के कर्नेल वही आर्काइव लिखते हैं जो पोर्टेबल कोड लिखता है।
- प्रशिक्षण किसी भी हार्डवेयर पर चलता है, ग्राफ़िक्स कार्ड सहित: कोडिंग की ओर केवल वेट जाते हैं।
Wikipedia के एक गीगाबाइट पर मापा गया
प्रोग्राम ने रिपॉज़िटरी के नेटवर्क और डिफ़ॉल्ट विकल्पों के साथ, Intel Core Ultra 9 275HX के एक कोर पर enwik9 को कंप्रेस और डीकंप्रेस किया। डीकंप्रेस की गई फ़ाइल इनपुट से बाइट-दर-बाइट मेल खाती है।
| आर्काइव | 117,169,624 बाइट |
|---|---|
| बिट प्रति बाइट | 0.937 |
| डीकंप्रेसर, टोकनाइज़र और नेटवर्क सहित | 7,063,888 बाइट |
| एक दिशा का समय, एक कोर | लगभग 25 घंटे |
| प्रोसेसर द्वारा चुने गए कर्नेल के साथ संपीड़न | 30 घं 18 मि के बजाय 24 घं 48 मि |
आर्काइव के साथ दी जाने वाली सामग्री
टोकनाइज़र और 6 बिट पर क्वांटाइज़्ड वेट, डेटा के रूप में प्रोग्राम में कंपाइल होते हैं। वही सोर्स अकेला डीकंप्रेसर भी बनाता है, अपने डेटा के अलावा लगभग 320 KB कोड, एक ही कंपाइलर कमांड से और बिना कोई लाइब्रेरी इंस्टॉल किए।
संपीड़न से आगे इस उदाहरण की सीख
बिट प्रति बाइट, अगले टोकन के लक्ष्य को ऐसी मात्रा में बदल देता है जिसे कोई भी जाँच सकता है। और यह तरीका तब-तब लागू होता है जब किसी प्रशिक्षित नेटवर्क को दो मशीनों पर एक जैसे परिणाम देने हों: कहीं भी प्रशिक्षित करें, वेट को डेटा के रूप में भेजें, और इन्फ़रेंस ऐसी गणना में चलाएँ जिसका हर ऑपरेशन तय है।
अपनी फ़ाइलें कंप्रेस करें
रिपॉज़िटरी एक पहले से प्रशिक्षित नेटवर्क देती है: बिल्ड होते ही प्रोग्राम तुरंत कंप्रेस करता है।