
Сжатие через предсказание
Языковая модель задаёт вероятность того, что будет дальше, а арифметический кодер превращает вероятность в биты. Чем лучше предсказание, тем короче файл. Один пример из библиотеки строит всю цепочку и измеряет её.
- 0,937
- бита на байт на гигабайте текста Википедии
- 7,9 млн
- параметров в предсказывающей сети
- 107
- контекстных моделей, уточняющих её предсказание
- 1
- исходный файл для компрессора и декомпрессора
Модель, которая хорошо предсказывает, хорошо сжимает
Кодирование символа стоит логарифм вероятности, которую модель ему дала: длина архива равна перекрёстной энтропии модели на данных. Поэтому обучить сеть предсказывать следующий токен и сжать текст означает решить одну и ту же задачу, а размер архива становится честной мерой того, что сеть выучила.
Две программы, от байтов к токенам
Байт за байтом, для любого файла
Небольшой трансформер предсказывает следующий байт любого файла. Один бит говорит, угадал ли он, промахи записываются целиком, а модель может ехать внутри архива, который тогда распаковывается сам.
slm_predictive_compressor_ex.cpp
Токен за токеном, для текста
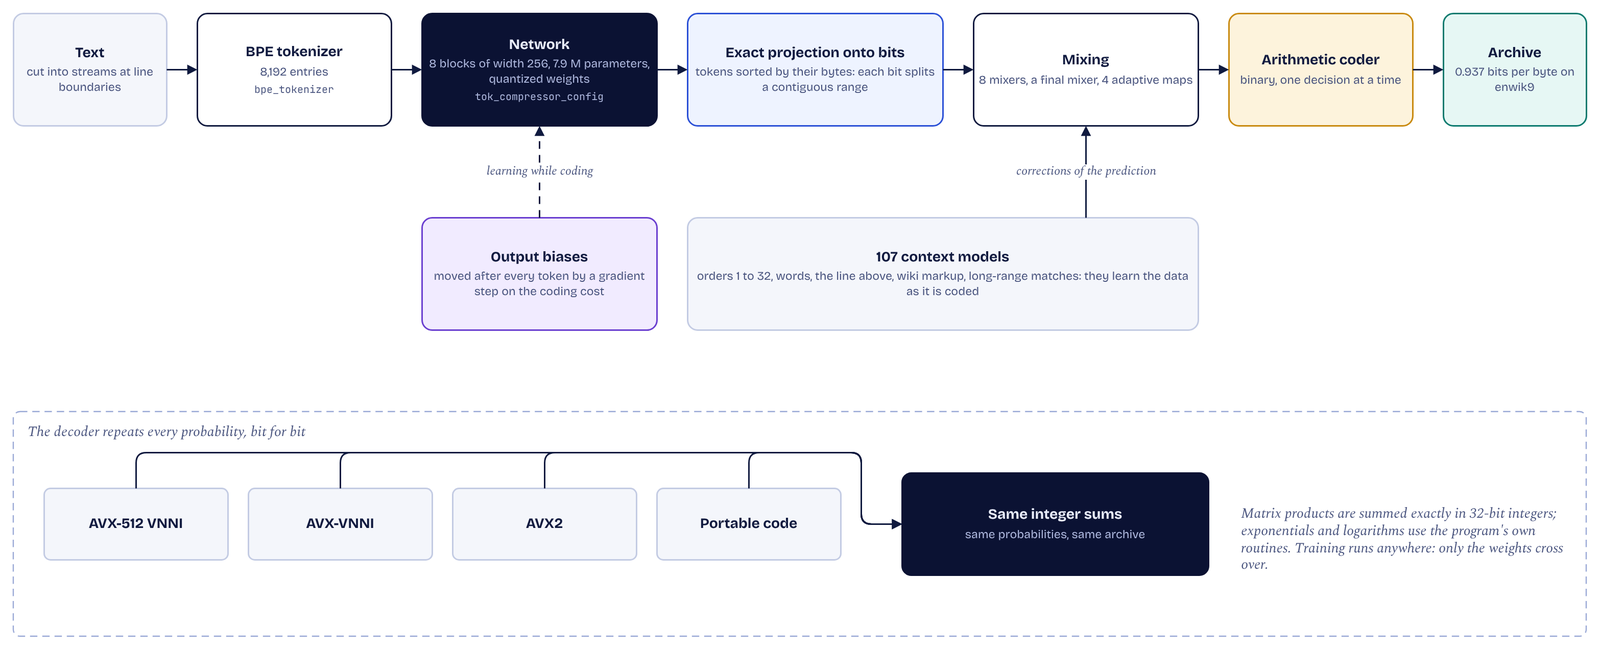
Декодер из восьми блоков предсказывает токены, контекстные модели учат текст по мере кодирования, и всё это компилируется в программу вместе с токенизатором. Именно эта версия измерена ниже.
slm_tok_predictive_compressor_ex.cpp
От токена к битам
- Сеть даёт вероятность каждому из 8 192 токенов словаря.
- Токены упорядочены по своим байтам: каждый бит следующего байта делит непрерывный диапазон, и вероятность бита вычисляется точно, без приближений.
- 107 контекстных моделей хранят историю уже закодированных битов, от последнего байта до совпадений, найденных далеко позади в тексте.
- Восемь смесителей, итоговый смеситель и четыре адаптивных отображения объединяют эти предсказания, решение за решением.
- Двоичный арифметический кодер записывает результат. Тем временем выходные смещения сети сдвигаются после каждого токена, и декодер делает те же шаги.
Одни и те же биты на любой машине
Декодер должен получить каждую вероятность, использованную кодером, до последнего бита, иначе он декодирует что-то другое. Но результаты с плавающей точкой зависят от процессора, библиотеки и порядка сумм. Поэтому у пути кодирования своя арифметика.
- Матричные произведения выполняются на целых числах и суммируются точно в 32 битах: сумма целых не зависит от порядка.
- Экспоненты, логарифмы и повороты используют собственные процедуры программы, построенные на базовых операциях IEEE.
- Ядра для AVX-512 VNNI, AVX-VNNI и AVX2 записывают тот же архив, что и переносимый код.
- Обучение идёт на любом оборудовании, включая видеокарту: на сторону кодирования переходят только веса.
Измерено на гигабайте Википедии
Программа сжала и распаковала enwik9 с сетью из репозитория и параметрами по умолчанию, на одном ядре Intel Core Ultra 9 275HX. Распакованный файл совпадает с исходным байт в байт.
| Архив | 117 169 624 байта |
|---|---|
| Бит на байт | 0,937 |
| Декомпрессор, включая токенизатор и сеть | 7 063 888 байт |
| Время в одну сторону, одно ядро | Около 25 часов |
| Сжатие с ядрами, выбранными по процессору | 24 ч 48 мин вместо 30 ч 18 мин |
Состав поставки архива
Токенизатор и веса, квантованные до 6 бит, скомпилированы в программу как данные. Тот же исходный код собирает отдельный декомпрессор, около 320 КБ кода помимо данных, одной командой компилятора и без установки библиотек.
Уроки примера за пределами сжатия
Биты на байт превращают цель «следующий токен» в величину, которую может проверить каждый. А сам приём годится всякий раз, когда обученная сеть должна давать одинаковые результаты на двух машинах: обучать где угодно, поставлять веса как данные и выполнять инференс в арифметике, где каждая операция зафиксирована.
Сожмите собственные файлы
Репозиторий предоставляет уже обученную сеть: после сборки программа сжимает сразу.