
予測による圧縮
言語モデルは「次に何が来るか」の確率であり、算術符号化器は確率をビットに変えます。予測が良いほど、ファイルは短くなります。ライブラリの例題プログラムの 1 つが、この連鎖全体を構築し、測定します。
- 0.937
- ビット/バイト(ウィキペディアのテキスト 1 ギガバイト)
- 7.9 M
- 予測を行うネットワークのパラメーター数
- 107
- その予測を補正する文脈モデルの数
- 1
- 圧縮器と展開器を兼ねるソースファイルの数
よく予測するモデルは、よく圧縮する
記号を符号化するコストは、モデルがその記号に与えた確率の対数です。つまりアーカイブの長さは、データに対するモデルの交差エントロピーです。したがって、次のトークンを予測するようネットワークを学習することと、テキストを圧縮することは同じ問題であり、アーカイブのサイズはネットワークが学んだことの正直な尺度になります。
2 つのプログラム、バイトからトークンへ
バイト単位、あらゆるファイルに
小さな transformer が、任意のファイルの次のバイトを予測します。当たったかどうかを 1 ビットで示し、外れたバイトはそのまま書き込みます。モデルをアーカイブに同梱すれば、アーカイブは単独で展開できます。
slm_predictive_compressor_ex.cpp
トークン単位、テキストに
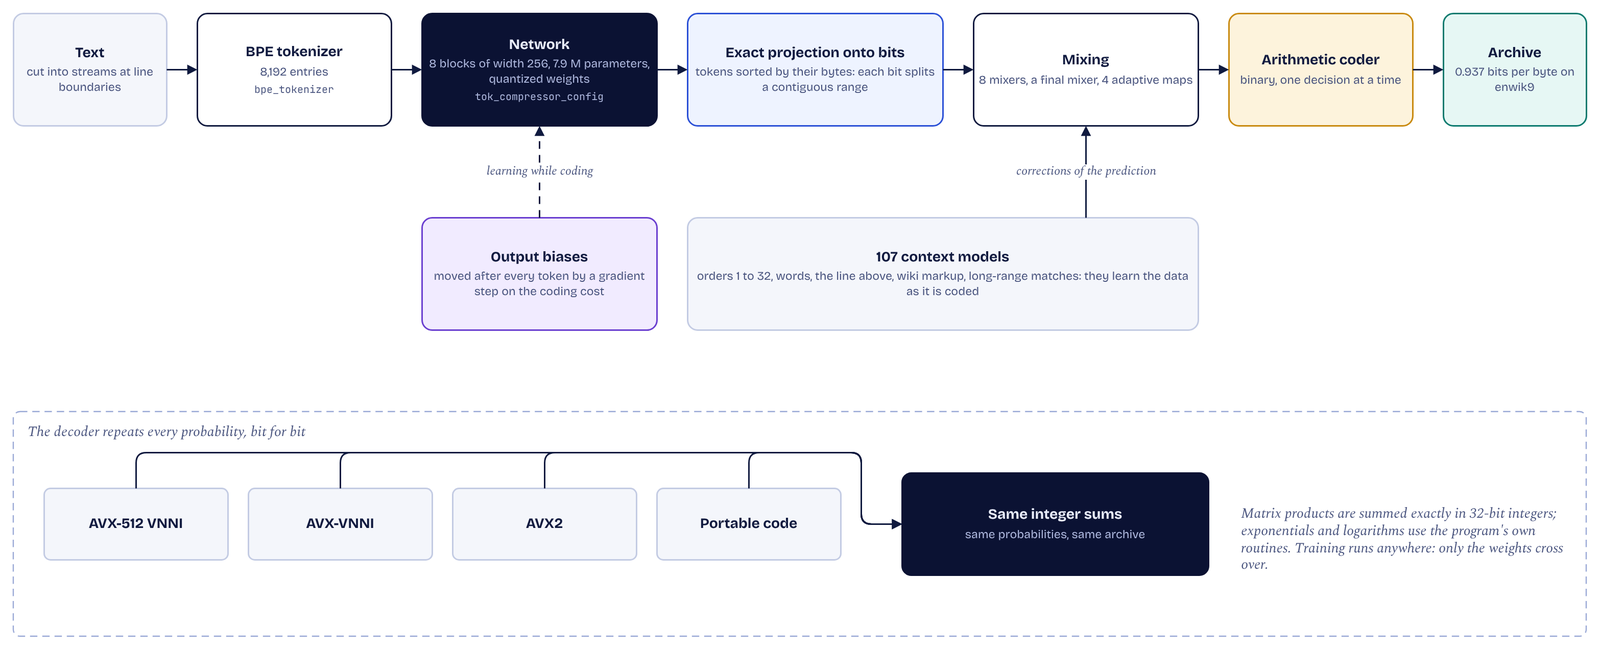
8 ブロックのデコーダーがトークンを予測し、文脈モデルが符号化しながらテキストを学習します。両者はトークナイザーとともにプログラムにコンパイルされます。以下で測定しているのはこの版です。
slm_tok_predictive_compressor_ex.cpp
トークンがビットになるまで
- ネットワークが、語彙の 8,192 個のトークンそれぞれに確率を与えます。
- トークンはバイト列の順に並んでいます。次のバイトの各ビットが連続した範囲を 2 つに分けるため、ビットの確率は近似なしに正確に計算できます。
- 107 個の文脈モデルが、直前のバイトからテキストのはるか前方で見つかった一致まで、すでに符号化したビットの履歴を保持します。
- 8 個のミキサー、最終ミキサー、4 個の適応マップが、これらの予測を判定ごとに組み合わせます。
- 2 値の算術符号化器が結果を書き込みます。その間、ネットワークの出力バイアスはトークンごとに動き、デコーダーも同じ手順を踏みます。
どのマシンでも同じビット
デコーダーは、エンコーダーが使ったすべての確率を最後の 1 ビットまで再現しなければなりません。さもなければ別のものを復号してしまいます。ところが浮動小数点の結果は、プロセッサー、ライブラリ、加算の順序によって変わります。そのため、符号化の経路は独自の算術を持っています。
- 行列積は整数で計算し、32 ビットで正確に加算します。整数の和は順序に依存しません。
- 指数、対数、回転には、IEEE の基本演算から組み立てたプログラム独自のルーチンを使います。
- AVX-512 VNNI、AVX-VNNI、AVX2 のカーネルは、可搬コードと同じアーカイブを書き出します。
- 学習はグラフィックカードを含むどのハードウェアでも実行できます。符号化側に渡るのは重みだけです。
ウィキペディア 1 ギガバイトでの実測
プログラムは、リポジトリのネットワークと既定のオプションを使い、Intel Core Ultra 9 275HX の 1 コアで enwik9 を圧縮し、展開しました。展開したファイルは入力とバイト単位で一致します。
| アーカイブ | 117,169,624 バイト |
|---|---|
| 1 バイトあたりのビット数 | 0.937 |
| 展開プログラム(トークナイザーとネットワークを含む) | 7,063,888 バイト |
| 片方向の所要時間、1 コア | 約 25 時間 |
| プロセッサーが選んだカーネルでの圧縮 | 30 時間 18 分が 24 時間 48 分に |
アーカイブに同梱されるもの
トークナイザーと 6 ビットに量子化した重みは、データとしてプログラムにコンパイルされます。同じソースから展開器だけをビルドでき、データを除くコードは約 320 KB、コンパイラーのコマンド 1 つで済み、ライブラリのインストールも不要です。
圧縮を超えた、この例題の教訓
ビット/バイトは、次トークン予測という目標を、誰でも確認できる量に変えます。そしてこの方法は、学習済みネットワークが 2 台のマシンで同一の結果を出さなければならない場面すべてに当てはまります。どこででも学習し、重みをデータとして届け、すべての演算を固定した算術で推論を実行するのです。